Ordem de crescimento assintótico (Big-Oh)
Ao longo deste capítulo, o custo de tempo e de espaço de cada algoritmo é indicado por meio da notação assintótica (em particular, a notação Big-Oh), escrita como . O objetivo aqui é oferecer uma noção de como interpretá-la.
A notação descreve a ordem de crescimento de uma função, isto é, como o custo de um algoritmo escala à medida que o tamanho da entrada cresce (). Quando dizemos que um algoritmo é , leia-se “cresce na ordem de ”: dobrar o tamanho da entrada tende a quadruplicar o custo. O foco recai sobre a tendência de crescimento, não sobre o valor exato do número de operações.
Um aspecto essencial é que constantes multiplicativas e termos de ordem inferior são desprezíveis (e, portanto, ignorados) quando a variável da função assume valores muito altos. Considere, por exemplo, uma função como : embora tenha coeficientes e termos extras, trata-se de um polinômio de grau 2 — sua curva tem o mesmo formato de , uma parábola. Como o interesse está no comportamento quando é grande, constantes não alteram a natureza nem o formato da curva de crescimento. Isso permite comparar algoritmos de forma abstrata, independente de detalhes de hardware ou implementação.
A escolha de um algoritmo com complexidade eficiente é crucial. A diferença entre e pode parecer pequena à primeira vista, mas cresce drasticamente: para , enquanto — mil vezes mais operações. Por isso, ao longo do texto, prestaremos atenção não apenas à corretude de cada algoritmo, mas também à sua classe de complexidade, que determina sua viabilidade em instâncias grandes.
Diferentemente de problemas cuja entrada é descrita por um único tamanho , algoritmos em grafos dependem de duas variáveis que descrevem o tamanho da entrada:
: número de vértices
: número de arestas
Isso é fundamental para interpretar as complexidades deste capítulo. A quantidade de arestas varia de 0 (grafo sem arestas) até (grafo completo), de modo que expressões como e representam realidades distintas. Por exemplo, a lista de adjacência ocupa de espaço — eficiente para grafos esparsos —, enquanto a matriz de adjacências sempre ocupa , independentemente de . Ler exige ter ambas as variáveis em mente: se o grafo for denso (), então ; se for esparso (), então .
A tabela abaixo resume as complexidades mais comuns nos algoritmos de grafos que aparecerão ao longo deste capítulo, interpretadas em termos de (vértices) e (arestas):
| Notação | Intuição (em grafos) | Exemplo no capítulo |
|---|---|---|
| independe de e | inserir aresta na matriz | |
| linear no grafo; cada vértice/aresta é processado poucas vezes | BFS, DFS | |
| quase-linear; típico de filas de prioridade (heap) | Dijkstra, Prim | |
| relaxa todas as arestas para cada vértice | Bellman-Ford | |
| quadrático em vértices; natural em matrizes | espaço da matriz de adjacências | |
| três laços aninhados sobre os vértices | Warshall, Floyd-Warshall |
Observe como a mesma notação pode comportar-se de forma distinta conforme a densidade do grafo. Ao aproximarmos em função de , a função efetivamente plotada fica explícita: no caso esparso (), ; no caso denso (), . A figura abaixo deixa essas substituições visíveis nos rótulos de cada curva. O eixo horizontal representa o número de vértices — as arestas variam conforme o regime de densidade.
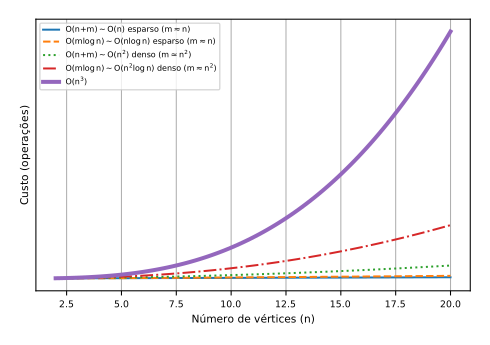
Crescimento de complexidades em grafos: esparso vs. denso
5.1 Representações de grafos
5.1.1 Introdução
, número de vértices, número de arestas. Duas representações básicas:
| Estrutura | Ideia | Melhor para |
|---|---|---|
| Matriz de adjacências | matriz ; M[u][v] = 1 se há aresta | grafos densos |
| Lista de adjacência | LA[u] contém apenas os vizinhos de | grafos esparsos |
Densidade : → denso (matriz); → esparso (lista).
5.1.2 Matriz de adjacências
M[u][v] vale 1 se existe a aresta , 0 caso contrário.
    0 1 2 3 4
  ┌───────────┐
0 │ 0 1 1 0 0 │
1 │ 0 0 1 1 0 │
2 │ 0 0 0 0 1 │
3 │ 0 0 0 0 1 │
4 │ 0 0 0 0 0 │
  └───────────┘
Implementação em C
#include <stdio.h>

#define MAXN 100

int main() {
    int n, m;

    // matriz de adjacência, inicializada com zeros
    int MA[MAXN][MAXN] = {0};

    // leitura: n vértices e m arestas
    scanf("%d %d", &n, &m);

    for (int i = 0; i < m; i++) {
        int u, v;
        scanf("%d %d", &u, &v);
        MA[u][v] = 1;           // digrafo: aresta u -> v
        // MA[v][u] = 1;       // não-direcionado: descomente esta linha
    }

    // impressão da matriz n x n
    for (int u = 0; u < n; u++) {
        for (int v = 0; v < n; v++)
            printf("%d ", MA[u][v]);
        printf("\n");
    }

    return 0;
}
Implementação em C++
#include <iostream>
#include <vector>
using namespace std;

int main() {
    int n, m;
    cin >> n >> m;

    // matriz n x n inicializada com 0
    vector<vector<int>> MA(n, vector<int>(n, 0));

    for (int i = 0; i < m; i++) {
        int u, v;
        cin >> u >> v;
        MA[u][v] = 1;           // digrafo: aresta u -> v
        // MA[v][u] = 1;       // não-direcionado: descomente esta linha
    }

    // impressão da matriz
    for (int u = 0; u < n; u++) {
        for (int v = 0; v < n; v++) {
            cout << MA[u][v] << " ";
        }
        cout << "\n";
    }

    return 0;
}
vectoré um array dinâmico: cresce automaticamente,push_backanexa ao final em amortizado.
Complexidade
| Operação | Custo |
|---|---|
| Espaço | |
| Inserir / consultar aresta | |
| Iterar vizinhos de |
5.1.3 Lista de adjacência
LA[u] guarda apenas os vizinhos de — espaço proporcional a , não a .
LA[0] -> 1 -> 2
LA[1] -> 2 -> 3
LA[2] -> 4
LA[3] -> 4
LA[4] -> (vazia)
Implementação em C (lista ligada)
#include <stdio.h>
#include <stdlib.h>

#define MAXN 1000

typedef struct no {
    int v;               // vértice de destino
    struct no* prox;     // próximo nó da lista
} no;

// LA[u] aponta para o primeiro vizinho de u (NULL se não houver)
no* LA[MAXN];

// insere v na lista de adjacência de u (inserção no início: O(1))
void insere(int u, int v) {
    no* novo = (no*) malloc(sizeof(no));
    novo->v = v;
    novo->prox = LA[u];
    LA[u] = novo;
}

int main() {
    int n, m;
    scanf("%d %d", &n, &m);

    for (int i = 0; i < m; i++) {
        int u, v;
        scanf("%d %d", &u, &v);
        insere(u, v);            // digrafo: aresta u -> v
        // insere(v, u);        // não-direcionado: descomente esta linha
    }

    // impressão
    for (int u = 0; u < n; u++) {
        printf("%d:", u);
        for (no* p = LA[u]; p != NULL; p = p->prox)
            printf(" %d", p->v);
        printf("\n");
    }

    // liberação de memória
    for (int u = 0; u < n; u++) {
        no* p = LA[u];
        while (p != NULL) {
            no* tmp = p;
            p = p->prox;
            free(tmp);
        }
    }

    return 0;
}
Inserção no início é mas inverte a ordem dos vizinhos.
Implementação em C++ (vector)
#include <iostream>
#include <vector>
using namespace std;

typedef vector<int> vi;    // apelido: "lista de vizinhos"

int main() {
    int n, m;
    cin >> n >> m;

    // vetor de n listas de adjacência
    vi* LA = new vi[n];

    for (int i = 0; i < m; i++) {
        int u, v;
        cin >> u >> v;
        LA[u].push_back(v);     // digrafo: aresta u -> v
        // LA[v].push_back(u); // não-direcionado: descomente esta linha
    }

    // impressão (range-based for — C++11)
    for (int u = 0; u < n; u++) {
        cout << u << ":";
        for (int v : LA[u])
            cout << " " << v;
        cout << "\n";
    }

    delete[] LA;
    return 0;
}
Consultar se uma aresta existe
Não há acesso direto — é preciso percorrer ():
// C
int existe_aresta(no** LA, int u, int v) {
    for (no* p = LA[u]; p != NULL; p = p->prox) {
        if (p->v == v) return 1;
    }
    return 0;
}
// C++
bool existe_aresta(vi* LA, int u, int v) {
for (int vizinho : LA[u]) {
if (vizinho == v) return true;
}
return false;
}Complexidade
| Operação | Custo |
|---|---|
| Espaço | |
| Inserir aresta | |
| Consultar aresta | |
| Iterar vizinhos de |
5.1.4 Extensão para grafos ponderados
Em C (struct com peso)
#include <stdio.h>
#include <stdlib.h>

#define MAXN 1000

typedef struct aresta {
    int v;               // vértice de destino
    int w;               // peso da aresta
    struct aresta* prox;
} aresta;

aresta* LA[MAXN];

void insere(int u, int v, int w) {
    aresta* novo = (aresta*) malloc(sizeof(aresta));
    novo->v = v;
    novo->w = w;
    novo->prox = LA[u];
    LA[u] = novo;
}

int main() {
    int n, m;
    scanf("%d %d", &n, &m);

    for (int i = 0; i < m; i++) {
        int u, v, w;
        scanf("%d %d %d", &u, &v, &w);
        insere(u, v, w);          // digrafo ponderado: u -> v com peso w
        // insere(v, u, w);      // não-direcionado: descomente
    }

    for (int u = 0; u < n; u++) {
        printf("%d:", u);
        for (aresta* p = LA[u]; p != NULL; p = p->prox)
            printf(" (%d,%d)", p->v, p->w);
        printf("\n");
    }

    // liberação (mesma lógica da versão sem peso)
    for (int u = 0; u < n; u++) {
        aresta* p = LA[u];
        while (p != NULL) {
            aresta* tmp = p;
            p = p->prox;
            free(tmp);
        }
    }

    return 0;
}
Em C++ (pair)
pair<int,int> (biblioteca <utility>) agrupa (destino, peso) sem definir struct.
#include <iostream>
#include <vector>
#include <utility>   // pair, make_pair
using namespace std;

typedef pair<int,int> ii;       // (vértice destino, peso)
typedef vector<ii> vii;         // lista de adjacência ponderada

int main() {
    int n, m;
    cin >> n >> m;

    vii* LA = new vii[n];

    for (int i = 0; i < m; i++) {
        int u, v, w;
        cin >> u >> v >> w;
        LA[u].push_back(make_pair(v, w));    // aresta u -> v com peso w
        // LA[v].push_back(make_pair(u, w)); // não-direcionado: descomente
    }

    // impressão: a.first = vértice, a.second = peso
    for (int u = 0; u < n; u++) {
        cout << u << ":";
        for (ii a : LA[u])
            cout << " (" << a.first << "," << a.second << ")";
        cout << "\n";
    }

    delete[] LA;
    return 0;
}
Para matriz ponderada, troque
1/0pelo peso e use um sentinela (ex.:INT_MAX) para ausência de aresta.
5.1.5 Variantes avançadas
set/map (C++)
A lista com vector consulta arestas em . Substituindo o container, melhora-se a consulta:
| Container | Estrutura interna | Inserir | Consultar existe? | Ordem |
|---|---|---|---|---|
vector<int> | array dinâmico | amort. | inserção | |
set<int> | árvore rubro-negra | crescente | ||
unordered_set<int> | hash table | médio | médio | indefinida |
#include <iostream>
#include <set>
using namespace std;

typedef set<int> si;    // conjunto ordenado de vizinhos

int main() {
    int n, m;
    cin >> n >> m;

    // cada LA[u] é um set<int> (árvore balanceada)
    si* LA = new si[n];

    for (int i = 0; i < m; i++) {
        int u, v;
        cin >> u >> v;
        LA[u].insert(v);       // inserção O(log deg(u))
        // LA[v].insert(u);   // não-direcionado: descomente
    }

    // consulta: existe aresta u -> v?  O(log deg(u))
    // LA[u].count(v) retorna 1 se v está no conjunto, 0 caso contrário

    // impressão (set percorre em ordem crescente automaticamente)
    for (int u = 0; u < n; u++) {
        cout << u << ":";
        for (int v : LA[u])
            cout << " " << v;
        cout << "\n";
    }

    delete[] LA;
    return 0;
}
Para grafos ponderados: map<int,int> (árvore rubro-negra) mapeia vizinho peso; unordered_map (hash table) oferece médio.
typedef map<int,int> mii;    // vizinho -> peso
// LA[u][v] = w;      // define o peso da aresta u -> v
// LA[u].count(v);    // verifica se a aresta existe
Compressed Sparse Row (CSR)
Formato para processamento de grafos muito usado em álgebra linear esparsa (exemplo: processamento de grafos em GPU). Dois arrays contíguos:
| Array | Conteúdo | Tamanho |
|---|---|---|
col_idx[] | vértice de destino de cada aresta, agrupado por origem | |
row_ptr[] | índice inicial de cada vértice em col_idx (soma prefixa dos graus) |
Número de vizinhos de : row_ptr[u+1] - row_ptr[u].
for (i = row_ptr[u]; i < row_ptr[u+1]; i++) {
    v = col_idx[i];
}
#include <iostream>
#include <vector>
using namespace std;
int main() {
int n, m;
cin >> n >> m;
// leitura das arestas
vector<int> origem(m), destino(m);
for (int i = 0; i < m; i++)
cin >> origem[i] >> destino[i];
// 1. contar grau de cada vértice
vector<int> row_ptr(n + 1, 0);
for (int i = 0; i < m; i++)
row_ptr[origem[i] + 1]++;
// 2. soma prefixa: row_ptr[u] = início dos vizinhos de u em col_idx
for (int u = 0; u < n; u++)
row_ptr[u + 1] += row_ptr[u];
// 3. preencher col_idx (preserva a ordem de leitura das arestas)
vector<int> col_idx(m);
vector<int> pos = row_ptr; // posição de escrita atual por vértice
for (int i = 0; i < m; i++) {
int u = origem[i];
col_idx[pos[u]] = destino[i];
pos[u]++;
}
// impressão
for (int u = 0; u < n; u++) {
cout << u << ":";
for (int i = row_ptr[u]; i < row_ptr[u + 1]; i++)
cout << " " << col_idx[i];
cout << "\n";
}
return 0;
}Para grafos ponderados, adicione um array
values[]paralelo acol_idx[].
5.1.6 Entrada de exemplo e compilação
Salve como input.txt:
5 6
0 1
0 2
1 2
1 3
2 4
3 4
# C
gcc matriz-adjacencias.c -o matriz-c
gcc lista-adjacencia.c -o lista-c
# C++
g++ -std=c++17 matriz-adjacencias.cpp -o matriz-cpp
g++ -std=c++17 lista-adjacencia.cpp -o lista-cpp
g++ -std=c++17 lista-set.cpp -o lista-set
g++ -std=c++17 csr.cpp -o csr
# Executar (todos leem o mesmo input.txt)
./matriz-c < input.txt
./lista-c < input.txt
./matriz-cpp < input.txt
./lista-cpp < input.txt
./lista-set < input.txt
./csr < input.txtSaída esperada da matriz:
0 1 1 0 0
0 0 1 1 0
0 0 0 0 1
0 0 0 0 1
0 0 0 0 0
Saída esperada da lista (C++, com push_back — preserva ordem de inserção):
0: 1 2
1: 2 3
2: 4
3: 4
4:
Em C (lista ligada com inserção no início), a ordem dos vizinhos aparece invertida.
Para a versão ponderada, use uma entrada com três valores por linha:
5 6
0 1 10
0 2 5
1 2 2
1 3 7
2 4 3
3 4 1
5.2 Fecho transitivo (algoritmo de Warshall)
O fecho transitivo de um grafo direcionado é o grafo onde contém todo par tal que existe um caminho de a em . Frequentemente, nos referimos ao algoritmo que computa essa propriedade através do nome de seu autor (Algoritmo de Warshall). A ideia central é estender progressivamente o conjunto de vértices intermediários permitidos: a cada passo , verificamos se incluir como intermediário cria novos caminhos entre pares de vértices. O algoritmo de Warshall é fundamental por (1) determinar a alcançabilidade entre todos os pares de vértices; (2) revelar a estrutura de conectividade do grafo; (3) servir como base para o algoritmo de Floyd-Warshall, que estende a mesma estrutura para caminhos mínimos ponderados. De fato, como exemplo, o fecho transitivo é geralmente usado para verificar se um grafo é fortemente conectado e para identificar componentes fortemente conectados.
O pseudocódigo é indicado abaixo, mas algumas informações são importantes:
A entrada é um grafo direcionado com matriz de adjacências de dimensão
O algoritmo computa uma sequência de matrizes , onde se, e somente se, existe caminho de a usando apenas vértices intermediários em
Caso base (): apenas arestas diretas são consideradas: sse existe a aresta . Isto é, inicialmente a própria matriz de adjacências.
Recorrência: — ou já existe caminho sem , ou passa por
Resultado final: é o fecho transitivo de
WARSHALL(G)
// argumentos:
// G: grafo direcionado com vértices V e matriz de adjacências G.M (n x n)

W_0 = G.M                       // caso base: apenas arestas diretas
for k = 1 to n
   W_k = nova matriz (n x n)    // nova matriz alocada para este intermediário
   for u = 1 to n
      for v = 1 to n
         W_k[u][v] = W_{k-1}[u][v] OR (W_{k-1}[u][k] AND W_{k-1}[k][v])
return W_n
Complexidade de tempo: Observe que, sendo a quantidade de vértices do grafo, temos três laços aninhados cada um executando uma quantidade fixa de iterações (). Assim, temos um algoritmo que totaliza uma ordem de operações.
Complexidade de espaço: O algoritmo aloca uma nova matriz W_i de tamanho a cada iteração de vértices intermediários , totalizando na ordem de espaço gasto. É possível otimizar o custo de espaço de para atualizando a mesma matriz in-place a cada iteração . Isso é seguro porque a -ésima linha e coluna não se alteram: como W_{k-1}[k][k] = 1, temos W_k[u][k] = W_{k-1}[u][k] OR (W_{k-1}[u][k] AND 1) = W_{k-1}[u][k], e analogamente W_k[k][v] = W_{k-1}[k][v]. Logo, os valores lidos durante a atualização in-place são exatamente os mesmos que seriam lidos da matriz anterior.
5.3 Caminhamento em largura (Breadth-first search - BFS)
Um caminhamento (ou busca) em largura é um procedimento cujo objetivo é visitar (encontrar) cada vértice de um grafo e, naturalmente, seguindo as arestas. Frequentemente, nos referimos a essa busca através do nome em inglês e sua sigla (Breadth-First Search - BFS). Busca em largura significa que os vizinhos de um vértice são todos visitados antes que possamos cogitar visitar vizinhos dos vizinhos (remete a uma ideia de fila FIFO). A BFS é um algoritmo tão fundamental que é utilizada para (1) extrair propriedades estruturais de um grafo; (2) consultar atributos de vértices e arestas de forma ordenada e eficiente; (3) como subrotina de outras tarefas em grafos. De fato, como exemplo, a BFS é geralmente é usada para encontrar distâncias mínimas de um vértice a todos os outros em relação ao número de arestas.
O pseudocódigo é indicado abaixo, mas algumas informações são importantes:
A entrada é um grafo não-ponderado e um vértice de partida ()
O algoritmo marca três informações para cada vértice: sua cor, sua distância partindo de , qual vértice (pai) o descobriu
Cores (): [WHITE] indica que o vértice ainda não foi descoberto; [GRAY] indica que o vértice foi descoberto porém não foi visitado; [BLACK] vértice descoberto e visitado
Distância (): indica quantas arestas existem partindo de com destino a , considerando a busca em largura
Predecessor/pai (): marca, para cada vértice, quem foi o vértice que o descobriu -- naturalmente ninguém descobre
bfs(G, s)
// argumentos:
// G: grafo com vértices V e listas de adjacências Adjlist
// s: vértice fonte que representa o ponto de partida da busca

  for each vertex u in G.V except s
    u.pi = NIL
    u.d = infinity
    u.color = WHITE
  s.color = GRAY
  s.d = 0
  s.pi = NIL
  Q = queue containing s
  while Q is not empty
    u = dequeue(Q) // próximo da fila FIFO
    for each v in G.AdjList[u]
      if v.color == WHITE
        v.color = GRAY
        v.pi = u
        v.d = u.d + 1
        enqueue(Q, v)
      u.color = BLACK    // BLACK: totalmente explorado
5.3.1 Grafos de exemplo para exercitar BFS
Exemplos:
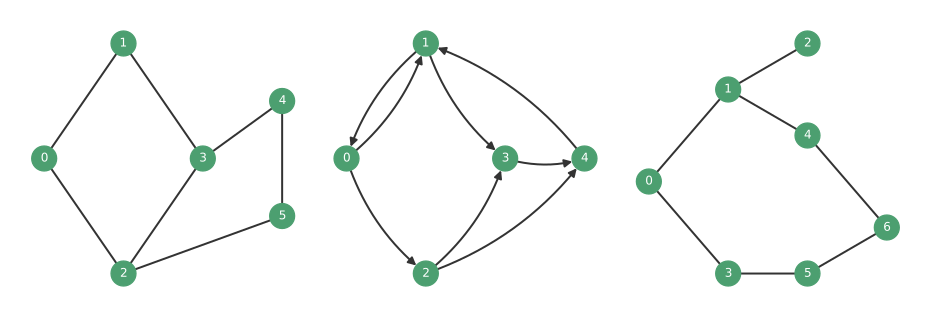
Grafos de exemplo para BFS
5.4 Caminhamento em profundidade (Depth-first search - DFS)
Um caminhamento (ou busca) em profundidade é um procedimento cujo objetivo é, assim como a busca em largura, visitar (encontrar) cada vértice de um grafo seguindo as arestas. Frequentemente, nos referimos a essa busca através do nome em inglês e sua sigla (Depth-First Search - DFS). Busca em profundidade significa que, a partir de um vértice, exploramos o mais profundamente possível cada ramo antes de retroceder (backtrack) e visitar outros vizinhos (remete a uma ideia de pilha LIFO, naturalmente implementada via recursão). A DFS é um algoritmo tão fundamental que é utilizada para (1) classificar arestas de um grafo direcionado; (2) realizar ordenação topológica em DAGs; (3) encontrar componentes fortemente conectados; (4) detectar ciclos. De fato, como exemplo, a DFS é geralmente usada para determinar a estrutura de ancestralidade entre vértices por meio dos tempos de descoberta e término.
O pseudocódigo é indicado abaixo, mas algumas informações são importantes:
A entrada é um grafo (direcionado ou não) — diferentemente da BFS, não há um vértice de partida fixo; o algoritmo percorre todos os vértices, iniciando uma busca sempre que encontra um vértice ainda não descoberto
O algoritmo marca quatro informações para cada vértice: sua cor, seu tempo de descoberta, seu tempo de término, qual vértice (pai) o descobriu
Cores (): [WHITE] indica que o vértice ainda não foi descoberto; [GRAY] indica que o vértice foi descoberto porém ainda está sendo explorado (há descendentes em processamento); [BLACK] vértice descoberto e totalmente explorado
Tempo de descoberta (): marca o instante em que o vértice foi descoberto (quando se torna GRAY)
Tempo de término (): marca o instante em que o vértice terminou de ser explorado (quando se torna BLACK)
Predecessor/pai (): marca, para cada vértice, quem foi o vértice que o descobriu -- naturalmente ninguém descobre a raiz de cada árvore da floresta de predecessores
dfs(G)
// argumentos:
// G: grafo com vértices V e listas de adjacências Adjlist

  for each vertex u in G.V
    u.color = WHITE
    u.pi = NIL
  for each vertex u in G.V
    if u.color == WHITE
      dfs-visit(G, u)

time = 0    // variável global para marcar os tempos dos vértices

dfs-visit(G, u)
// argumentos:
// G: grafo com vértices V e listas de adjacências Adjlist
// u: vértice a visitar

  time = time + 1
  u.d = time
  u.color = GRAY
  for each v in G.AdjList[u]
    if v.color == WHITE
      v.pi = u
      dfs-visit(G, v)
  u.color = BLACK
  time = time + 1
  u.f = time
O intervalo está totalmente contido dentro do intervalo sse é descendente de em alguma a´rvore na floresta de predecessores do DFS (ou vice versa)
O intervalo é totalmente disjunto de sse os dois vértices pertencem a árvores diferentes na floresta de predecessores do DFS.
Não é possível que intervalos tenham sobreposição mas que um não esteja totalmente contido dentro do outro: se isso pudesse acontecer, teríamos que o vértice ancestral seria terminado antes do seu descendente, o que contraria a definição de caminhamento em profundidade já que vértices ancestrais só terminam quando todos os seus descendentes tenham terminado.
5.4.1 Grafos de exemplo para exercitar DFS
Exemplos:
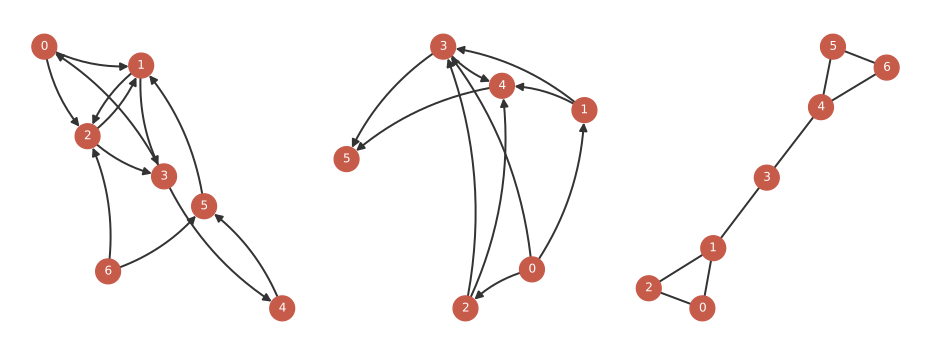
Grafos de exemplo para DFS
5.4.2 Classificação de arestas em DFS
Se considerarmos o caso mais geral com grafos direcionados, podemos classificar as arestas de um grafo em quatro categorias:
Arestas da árvore (tree edges) são aquelas que aparecem na floresta de predecessores – aquelas que são selecionadas para visitar novos vértices;
Arestas de volta (back edges) são aquelas que vão de um descendente para algum de seus ancestrais na árvore DFS;
Arestas avançadas (forward edges) são aquelas que vão de um vértice até algum de seus descendentes na árvore DFS;
Arestas de cruzamento (cross edges) são as outras arestas: pode acontecer entre vértices de diferentes árvores da floresta ou mesmo entre vértices da mesma árvore que não compartilham relação ancestral/descendente (irmãos, por exemplo);
Toda vez que visitamos um novo vértice v no DFS, digamos através da aresta , temos alguma informação sobre qual tipo de aresta ela será. Se a cor de v for , então a aresta é uma aresta da árvore (tree edge). Se a cor do vértice for , então a aresta é de volta (back). Se a cor de for , então a aresta pode ser avançada (forward) ou de cruzamento (cross). Podemos tirar essa última dúvida se a aresta é avançada ou de cruzamento ao observar os tempos de cada aresta: se além de ser , o intervalo de u for disjunto do intervalo de v então temos uma aresta de cruzamento sem relação ancestral/descendente; caso contrário, se os intervalos estiverem contido um dentro do outro, temos uma aresta avançada, já que a sobreposição indica ancestralidade (pela parentização).
5.4.3 Detecção de articulações e pontes
O algoritmo de Tarjan estende a DFS com dois atributos adicionais além dos já conhecidos (, , ):
Tempo de descoberta (): marca o instante em que foi descoberto, como no DFS padrão
Menor alcançável (): o menor tempo de descoberta alcançável a partir da subárvore DFS enraizada em , descendo por arestas de árvore e subindo por no máximo uma aresta de volta. Inicialmente e, durante o caminhamento, é atualizado ao considerar: (1) arestas de árvore — após visitar o filho ; (2) arestas de volta — quando é um ancestral.
Em grafos não direcionados, toda aresta de volta define um ciclo, de modo que rastreia, em essência, até onde os ciclos da subárvore conseguem subir em direção à raiz. Se , existe um ciclo que conecta a subárvore de a algum ancestral acima de , funcionando como caminho alternativo de conectividade. Se , nenhum ciclo escapa acima de e a subárvore pende isolada — justamente o que caracteriza articulações e pontes:
Se , a subárvore de não alcança ancestral de é articulação
Se , a subárvore de tampouco alcança é ponte
A raiz da DFS é articulação sse possui mais de um filho na floresta de predecessores
time = 0        // variável global para marcar os tempos dos vértices

tarjan-pontes-articulacoes(G)
// argumentos:
// G: grafo com vértices V e listas de adjacências Adjlist
// ART: conjunto global de articulações (vértices de corte)
// PONTES: conjunto global de pontes (arestas cuja remoção desconecta o grafo)

  ART = {}        // conjunto global de articulações
  PONTES = {}     // conjunto global de pontes
  for each vertex u in G.V
    u.color = WHITE
    u.pi = NIL
  for each vertex u in G.V
    if u.color == WHITE
      nchildren = dfs-tarjan(G, u)
      if nchildren > 1
        ART = ART union {u}     // raiz com mais de um filho é articulação
  return ART, PONTES

dfs-tarjan(G, u)
// argumentos:
// G: grafo com vértices V e listas de adjacências Adjlist
// u: vértice a visitar

  u.color = GRAY
  nchildren = 0
  time = time + 1
  u.d = time
  u.low = time
  for each v in G.AdjList[u]
    if v.color == WHITE     // (u,v) é aresta de árvore
      v.pi = u
      nchildren = nchildren + 1
      dfs-tarjan(G, v)
      if u.pi != NIL and v.low >= u.d
        ART = ART union {u}            // u (não-raiz) é articulação
      if v.low > u.d
        PONTES = PONTES union {(u,v)}  // (u,v) é ponte
      u.low = min(u.low, v.low)
    else if v != u.pi
      u.low = min(u.low, v.d)
  u.color = BLACK
  return nchildren
5.4.4 Ordenação topológica
A ideia é que vértices que terminam primeiro devem ser posicionados depois de todos os seus ancestrais na ordenação topológica.
Topological-Sort(G)
 // G: Grafo direcionado acíclico com vértices V e lista de adjacência AdjList

 chame DFS(G), registrando os tempos de término para cada vértice
 à medida que cada vértice termina, insira-o no início de uma lista ligada
 retorne a lista ligada de vértices
5.4.5 Encontrando componentes fortemente conectados
A ideia aqui é que ao executar o DFS em , sempre visitamos primeiro aqueles vértices de maior tempo de término em , ou seja, aqueles vértices que não possuem aresta para outros vértices posicionados antes na ordem topológica. Dessa forma, toda vez que um vértice branco é encontrado, podemos ter certeza de que ele pertence à componente atual e toda vez que encontramos vértices já terminados, sabemos se tratar de vértices cuja componente já determinamos em uma visita anterior.
STRONGLY-CONNECTED-COMPONENTS(G)
// G: Grafo direcionado com vértices V e lista de adjacência AdjList

1. chame DFS(G) para determinar os tempos de término de cada vértice do grafo
2. construa G^T, que representa G com suas arestas invertidas
3. chame DFS(G^T), visitando primeiro os vértices com maior tempo de término (passo 1)
4. cada árvore da floresta visitada pelo último caminhamento representa um componente fortemente conectado do grafo original
5.5 Árvores geradoras de custo mínimo
5.5.1 Algoritmo de Prim
Fazemos operações de EXTRACT-MIN, uma para cada vértice, totalizando . Além disso, no pior caso, as chaves dos vértices são atualizadas vezes, já que fazemos isso para as listas de adjacências do grafo. Como cada operação DECREASE-KEY custa , temos o total de .
A complexidade final depende da implementação da fila de prioridades utilizada. Para detalhes sobre as diferentes implementações (arranjo simples e heap binário), consulte a seção Filas de Prioridade do capítulo Estruturas de Dados.
mst-prim(G, w, r)
// argumentos:
// G: grafo com vértices V e arestas E
// w: função de peso das arestas
// r: vértice de partida

  for each u in V
    u.pi = NIL
    u.key = infinity
  r.key = 0
  Q = build-priority-queue(V)
  while Q is not empty
    u = extract-min(Q)
    for each vertex v in G.AdjList[u]
      if v in Q and w(u, v) < v.key
        v.key = w(u, v)
        v.pi = u
        decrease-key(Q, v, v.key)
Análise de complexidade
Usando arranjo simples:
| Operação | Chamadas | Custo por chamada | Custo total |
|---|---|---|---|
| build-priority-queue | 1 | ||
| extract-min | |||
| decrease-key | |||
| Total |
Usando heap binário:
| Operação | Chamadas | Custo por chamada | Custo total |
|---|---|---|---|
| build-priority-queue | 1 | ||
| extract-min | |||
| decrease-key | |||
| Total |
Observação: A escolha da estrutura de dados é crítica. Em grafos densos (), ambas as implementações resultam em ou , respectivamente. Em grafos esparsos (), o heap é significativamente superior: versus .
5.5.2 Algoritmo de Kruskal
O custo do algoritmo é dominado pela ordenação das arestas por peso, que leva . Além da ordenação, o algoritmo faz operações MAKE-SET e operações FIND-SET/UNION sobre a estrutura de conjuntos disjuntos. Com a implementação por florestas com union by rank e compressão de caminho, essas operações têm custo quase constante amortizado, totalizando um custo essencialmente linear que, como assumimos conectado (), é absorvido pela ordenação. O custo total é, portanto, e, como implica , podemos declará-lo como . Para detalhes sobre as implementações dessa estrutura, consulte a seção Conjuntos Disjuntos do capítulo Estruturas de Dados.
mst-kruskal(G, w)
// argumentos:
// G: grafo com vértices V e arestas E
// w: função de peso das arestas

  A = {}
  for each u in V
    make-set(u)
  E_sorted = sort-by-weight-nondecreasing(E, w) // ordena arestas por w em ordem não-decrescente
  for each (u, v) in E_sorted // em ordem
    if find-set(u) != find-set(v)
      A = A union {(u, v)}
      union(u, v)
5.6 Propriedades de caminhos mínimos
Desigualdade triangular:
O menor caminho entre e não pode ser maior do que o menor caminho entre e mais o custo da aresta , senão teríamos um caminho de custo menor para (contradição).Propriedade do limite superior:
É sempre verdade que a estimativa de menor caminho para , , é sempre maior do que o menor caminho real até :
.Propriedade do não-caminho:
Se não existir caminho entre dois vértices (grafo orientado), temos que:
.Propriedade da convergência:
Seja um caminho , se relaxamos a aresta depois de já termos encontrado o caminho mínimo para (isto é, ), então:
E o mais importante, essa estimativa ótima nunca mais será alterada.Propriedade do relaxamento de um caminho:
Seja um caminho mínimo , se relaxamos as arestas na ordem desse caminho, então a estimativa do menor caminho para se tornará o menor caminho real:
.Propriedade do predecessor:
Ao computar todas as estimativas para o menor caminho, , teremos uma árvore de caminhos mínimos cuja raiz é .
5.7 Caminhos mínimos a partir de uma única fonte
5.7.1 Algoritmo de Bellman-Ford
relax(u, v, w)
// argumentos:
// u: vértice de origem
// v: vértice de destino
// w: função de peso das arestas

  if v.d > u.d + w(u, v)
    v.d = u.d + w(u, v)
    v.pi = u
bellman-ford(G, w, s)
// argumentos:
// G: grafo com vértices V e arestas E
// w: função de peso das arestas
// s: vértice fonte
for each u in V
u.pi = NIL
u.d = infinity
s.d = 0
for i = 1 to n - 1
for each (u, v) in E
relax(u, v, w)
for each (u, v) in E
if v.d > u.d + w(u, v)
return false // existe ciclo negativo
return true5.7.2 Algoritmo de Dijkstra
Este algoritmo utiliza uma escolha gulosa de sempre escolher para alcançar em seguida o vértice não alcançado que tenha a menor estimativa de distância até o momento. A inteligência do algoritmo vem do fato de que ao se alcançar um novo vértice, temos a oportunidade de melhorar a estimativa de distância de todos aqueles vértices não alcançados e que sejam adjacentes ao novo vértice.
O algoritmo faz operações EXTRACT-MIN e faz operações DECREASE-KEY (que acontece quando relaxamos uma aresta e diminuímos a prioridade de um vértice). A complexidade final depende da implementação da fila de prioridades utilizada. Para detalhes sobre as diferentes implementações (arranjo simples e heap binário), consulte a seção Filas de Prioridade do capítulo Estruturas de Dados.
dijkstra(G, w, s)
// argumentos:
// G: grafo com vértices V e arestas E
// w: função de peso das arestas
// s: vértice fonte

  for each u in V
    u.pi = NIL
    u.d = infinity
  s.d = 0
  S = empty
  Q = build-priority-queue(V)
  while Q is not empty
    u = extract-min(Q)
    S = S union {u}
    for each vertex v in G.AdjList[u]
      if v in Q and v.d > u.d + w(u, v)
        v.d = u.d + w(u, v)
        v.pi = u
        decrease-key(Q, v, v.d)
Análise de complexidade
Usando arranjo simples:
| Operação | Chamadas | Custo por chamada | Custo total |
|---|---|---|---|
| build-priority-queue | 1 | ||
| extract-min | |||
| decrease-key | |||
| Total |
Usando heap binário:
| Operação | Chamadas | Custo por chamada | Custo total |
|---|---|---|---|
| build-priority-queue | 1 | ||
| extract-min | |||
| decrease-key | |||
| Total |
Observação: Assim como em Prim, a escolha da estrutura de dados é crítica. Em grafos esparsos (), o heap binário oferece uma melhoria significativa: versus .
5.7.3 Caminhos mínimos em DAGs
Em grafos acíclicos direcionados (DAG), não temos ciclos por definição. Isso facilita nossa tarefa de obter caminhos mínimos pois podemos estabelecer qual serão as ordens dos caminhos mínimos. Sabendo disso, podemos relaxar as arestas em uma ordem específica e pela propriedade do relaxamento de um caminho, estamos garantidos que teremos a estimativa ótima para cada vértice. A ordem assim mencionada é diretamente obtida a partir de uma ordenação topológica do grafo de entrada.
O algoritmo tem duas fases:
Ordenação topológica dos vértices de (seção 5.4.4)
Relaxamento das arestas nessa ordem: para cada vértice na ordem topológica, relaxamos todas as arestas que saem de , isto é, as arestas da lista de adjacência
A garantia de correção vem da propriedade da convergência (seção 5.6): quando processamos o vértice na ordem topológica, todos os vértices com arestas chegando em já foram processados e, portanto, todas as arestas que entram em já foram relaxadas. Isso quer dizer que já é o caminho mínimo real e não será mais alterado. Assim, ao relaxar as arestas que saem de , propagamos diretamente o custo ótimo para os vizinhos de . Uma única passada pelos vértices basta.
dag-shortest-paths(G, w, s)
// argumentos:
// G: grafo direcionado acíclico com vértices V e arestas E
// w: função de peso das arestas
// s: vértice fonte

  for each u in V
    u.pi = NIL
    u.d = infinity
  s.d = 0
  V_sorted = topological-sort(G)
  for each u in V_sorted // em ordem topológica
    for each v in G.AdjList[u] // arestas que saem de u
      if v.d > u.d + w(u, v) then // relaxa a aresta (u, v)
        v.d = u.d + w(u, v)
        v.pi = u
Duas observações importantes sobre esse algoritmo:
Pesos negativos são permitidos: como um DAG não possui ciclos, ciclos negativos são impossíveis por definição. Diferentemente de Dijkstra, que exige pesos não negativos, o relaxamento em ordem topológica alcança o ótimo mesmo com pesos negativos.
Custo linear : a ordenação topológica custa e cada aresta é relaxada uma única vez. Compare com as passadas sobre todas as arestas de Bellman-Ford, .
Ao final, os predecessores definem a árvore de caminhos mínimos com raiz em (propriedade do predecessor, seção 5.6). Observe que assim conseguimos obter os caminhos mínimos a partir de uma fonte em tempo linear .
5.7.4 Exercícios interessantes
Dois exercícios do CLRS 3ed. sobre o tema desta seção, com esboços de solução.
1 (crls 3ed. – 24.1.5) Dado um grafo direcionado com pesos nas arestas , . Forneça um algoritmo que encontre, para cada vértice , o valor .
Descrição de algoritmo: vamos substituir o procedimento RELAX do algoritmo de Bellman-Ford pelo procedimento RELAX-MIN abaixo. Outra modificação é inicializar os predecessores de cada vértice como eles próprios: para todo . Esse passo é necessário e coerente, já que e, portanto, representa um limite superior para a função em cada vértice.
relax-min(u, v, w)
// argumentos:
// u: vértice de origem
// v: vértice de destino
// w: função de peso das arestas

  if v.d > MIN(w(u, v), u.d + w(u, v))
    v.d = MIN(w(u, v), u.d + w(u, v))
    v.pi = u.pi // o predecessor de v é o predecessor de u: u ou u' != u
2 (crls 3ed. – 24.1.6) Suponha que um grafo direcionado com pesos nas arestas contenha um ciclo de peso negativo. Forneça um algoritmo eficiente para listar os vértices desse ciclo.
Ideia de algoritmo: faça um caminhamento em profundidade (DFS) no grafo mantendo a soma dos pesos acumulados no caminho. Se o caminhamento encontrar uma aresta de volta (back edge), então um ciclo foi encontrado e tem-se também a soma dos pesos do ciclo. Ao detectar esse ciclo negativo, interrompemos o caminhamento imprimindo os vértices do caminho de volta à raiz, isto é, nas voltas da recursão até o destino da aresta de volta encontrada. Isso pode ser implementado:
(1) executando o Bellman-Ford; (2) marcando para vértices alcançáveis através de vértices do ciclo negativo (DFS); (3) fazendo um novo DFS para detectar ciclo a partir de vértices cuja estimativa seja ; se encontrar aresta de volta (back edge, cinza), significa que um ciclo foi detectado.
5.8 Caminhos mínimos entre todos os pares de vértices
Vamos assumir que os pesos das arestas estão organizados em uma matriz quadrada e que uma matriz de predecessores armazena os caminhos mínimos entre cada par de vértices. Veremos que essa formulação nos ajudará a construir algoritmos para o caso em que os grafos são densos. A subestrutura de um caminho mínimo nos permite caracterizar uma equação para custos ótimos de subproblemas e também um algoritmo de programação dinâmica. Seja o custo de um caminho mínimo entre o vértice e . Sabemos que esse caminho pode ter, no máximo, arestas (onde é o número de vértices). Por isso, podemos caracterizar qualquer caminho mínimo em subcaminhos que usam uma quantidade de arestas. Seja o custo do caminho mínimo entre e que usa, no máximo, arestas:
Com essa equação, conseguimos dois algoritmos para o problema.
O primeiro constrói para todo par de vértices . Computar cada entrada da matriz requer tempo linear porque é o mínimo entre alternativas. Temos pares e isso quer dizer que cada passo custa . Temos ao todo passos até conseguir obter os menores caminhos com até arestas, totalizando . Podemos melhorar esse custo ao observar que esse processo iterativo é similar à multiplicação de matrizes e, portanto, podemos “dobrar” sucessivamente a quantidade de arestas consideradas e encontrar em menos passos, totalizando .
5.8.1 Algoritmo de Floyd-Warshall
Este algoritmo melhora a definição recursiva de custo de um caminho mínimo ao considerar quais vértices intermediários podem aparecer em um caminho mínimo. Se fixamos um vértice intermediário como , teremos . Veja que os vértices intermediários que aparecem no subcaminho não podem ser (mesma coisa para ). Dessa forma, podemos melhorar um custo de caminho que considere como vértice intermediário se já tivermos calculado os custos ótimos de caminhos que considerem como intermediário:
Na notação do pseudocódigo abaixo, corresponde a e corresponde a . Veja que agora continuamos com um algoritmo iterativo sobre matrizes, mas cada passo de refinamento requer custo constante e não linear. Portanto, temos iterações e cada uma custa , totalizando .
floyd-warshall(G)
// argumentos:
// G: grafo com vértices V e matriz de pesos G.W (n x n)

  D_0 = G.W                          // caso base: nenhum vértice intermediário
  for k = 1 to n
    D_k = nova matriz (n x n)
    for u = 1 to n
      for v = 1 to n
        D_k[u][v] = min(D_{k-1}[u][v], D_{k-1}[u][k] + D_{k-1}[k][v])
  return D_n
Veja que podemos melhorar esse custo de espaço do algoritmo de para . Podemos reconstruir também os caminhos mínimos além dos custos ótimos ao armazenar em outra matriz quais decisões a cada passo levaram ao melhor custo. Uma alternativa é guardar o índice do predecessor do vértice que levou ao melhor custo: considera como predecessores as arestas isoladas.
A versão abaixo implementa essa otimização: usa uma única matriz atualizada in-place (note que e não se alteram durante a iteração , logo a leitura é segura) e mantém a matriz de predecessores para reconstruir os caminhos mínimos.
floyd-warshall(G)
// argumentos:
// G: grafo com vértices V e matriz de pesos G.W (n x n)

  D = G.W
  for u = 1 to n
    for v = 1 to n
      if u != v and D[u][v] < ∞ then
        Π[u][v] = u
      else
        Π[u][v] = NIL
  for k = 1 to n
    for u = 1 to n
      for v = 1 to n
        if D[u][k] + D[k][v] < D[u][v] then
          D[u][v] = D[u][k] + D[k][v]
          Π[u][v] = Π[k][v]
  return D, Π
Exemplo passo a passo
Considere o grafo direcionado abaixo com 4 vértices e 6 arestas ponderadas:
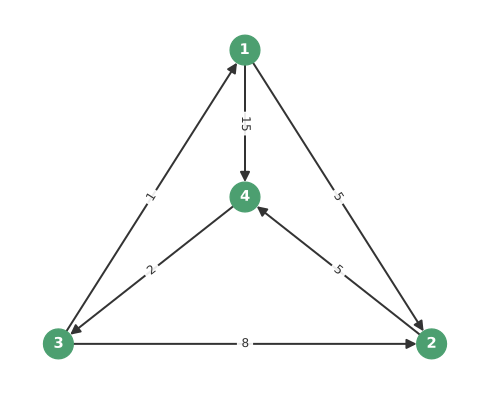
Grafo de exemplo para Floyd-Warshall
A matriz de custos inicial e a matriz de predecessores são:
k=0 (inicial):
    D (custos)                      Π (predecessores)
  ┌─────┬─────┬─────┬─────┐       ┌─────┬─────┬─────┬─────┐
  │   0 │   5 │   ∞ │  15 │       │   - │   1 │   - │   1 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   0 │   ∞ │   5 │       │   - │   - │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   1 │   8 │   0 │   ∞ │       │   3 │   3 │   - │   - │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   ∞ │   2 │   0 │       │   - │   - │   4 │   - │
  └─────┴─────┴─────┴─────┘       └─────┴─────┴─────┴─────┘

k=1:
    D (custos)                      Π (predecessores)
  ┌─────┬─────┬─────┬─────┐       ┌─────┬─────┬─────┬─────┐
  │   0 │   5 │   ∞ │  15 │       │   - │   1 │   - │   1 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   0 │   ∞ │   5 │       │   - │   - │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   1 │   6*│   0 │  16*│       │   3 │   1*│   - │   1*│
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   ∞ │   2 │   0 │       │   - │   - │   4 │   - │
  └─────┴─────┴─────┴─────┘       └─────┴─────┴─────┴─────┘

k=2:
    D (custos)                      Π (predecessores)
  ┌─────┬─────┬─────┬─────┐       ┌─────┬─────┬─────┬─────┐
  │   0 │   5 │   ∞ │  10*│       │   - │   1 │   - │   2*│
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   0 │   ∞ │   5 │       │   - │   - │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   1 │   6 │   0 │  11*│       │   3 │   1 │   - │   2*│
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   ∞ │   2 │   0 │       │   - │   - │   4 │   - │
  └─────┴─────┴─────┴─────┘       └─────┴─────┴─────┴─────┘

k=3:
    D (custos)                      Π (predecessores)
  ┌─────┬─────┬─────┬─────┐       ┌─────┬─────┬─────┬─────┐
  │   0 │   5 │   ∞ │  10 │       │   - │   1 │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   ∞ │   0 │   ∞ │   5 │       │   - │   - │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   1 │   6 │   0 │  11 │       │   3 │   1 │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   3*│   8*│   2 │   0 │       │   3*│   1*│   4 │   - │
  └─────┴─────┴─────┴─────┘       └─────┴─────┴─────┴─────┘

k=4:
    D (custos)                      Π (predecessores)
  ┌─────┬─────┬─────┬─────┐       ┌─────┬─────┬─────┬─────┐
  │   0 │   5 │  12*│  10 │       │   - │   1 │   4*│   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   8*│   0 │   7*│   5 │       │   3*│   - │   4*│   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   1 │   6 │   0 │  11 │       │   3 │   1 │   - │   2 │
  ├─────┼─────┼─────┼─────┤       ├─────┼─────┼─────┼─────┤
  │   3 │   8 │   2 │   0 │       │   3 │   1 │   4 │   - │
  └─────┴─────┴─────┴─────┘       └─────┴─────┴─────┴─────┘
Observe como cada iteração permite usar o vértice como intermediário. Por exemplo, em , o caminho (custo ) melhora a aresta direta (custo 8), e o predecessor de 2 no caminho mínimo a partir de 3 passa a ser 1. Em , o caminho (custo ) melhora a aresta direta (custo 15). A iteração revela caminhos que só se tornam ótimos quando o vértice 4 é permitido como intermediário, como (custo ).
5.8.2 Algoritmo de Johnson
5.9 Fluxo máximo
Uma rede de escoamento (ou rede de fluxo) é um grafo direcionado que modela a distribuição (o fluxo) de algum recurso a partir de um vértice fonte até um vértice de destino : o escoamento parte de e chega a , e cada aresta (arco) possui uma capacidade máxima. Exemplos de aplicação: líquidos em tubulações, corrente em uma rede elétrica, informação em redes de computadores e linhas de montagem.
Dado um grafo direcionado , uma fonte e um destino e capacidades nas arestas para cada , o objetivo é encontrar a quantidade máxima de fluxo que pode ser enviada a partir de até de forma que nenhuma capacidade seja violada.
A rede abaixo ilustra o problema: cada aresta traz a sua capacidade máxima.
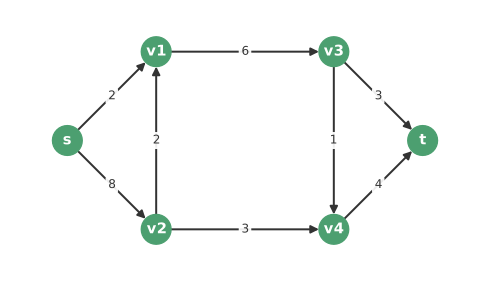
Rede de escoamento de s a t, com capacidades nas arestas
Trabalharemos com as seguintes premissas:
não existem arestas (arcos) anti-paralelos nem laços;
todo vértice está em algum caminho de a ;
capacidades e fluxos são números inteiros não negativos.
5.9.1 Propriedades de um fluxo
Restrição de capacidade. Para cada par de vértices, o fluxo não pode ultrapassar a capacidade:
Em particular, se , então : só circula fluxo pelas arestas do grafo. Na rede da figura anterior, por exemplo, .
Conservação do fluxo. Para cada vértice que não seja nem , a quantidade de fluxo “chegando” deve ser a mesma da quantidade de fluxo “saindo”:
As duas propriedades se combinam. A restrição de capacidade permite até 6 unidades em , mas a conservação impõe um limite menor: o vértice recebe fluxo apenas de (capacidade 2) e de (capacidade 2), de modo que no máximo 4 unidades podem passar por .
Para um algoritmo, não podemos preencher os fluxos das arestas arbitrariamente, pois aumentar o fluxo em algumas arestas pode impossibilitar que arestas mais vantajosas sejam exploradas. As redes residuais, apresentadas a seguir, auxiliam na identificação dessas oportunidades.
5.9.2 Redes residuais
Uma rede residual de um grafo indica, para cada par de vértices, qual é o potencial de aumentar ou diminuir o fluxo naquele ponto:
Se em temos com rótulo ( e ), então em temos a aresta com capacidade residual 4 (quanto ainda cabe) e a aresta com capacidade residual 6 (quanto se pode desfazer).
Se em temos com rótulo , não representamos a aresta de ida com capacidade residual 0, apenas com capacidade residual 6.
Quando aplicada ao grafo todo, a rede residual mostra as oportunidades de aumento do fluxo total. O exemplo abaixo mostra um fluxo com , em notação fluxo/capacidade (apenas a capacidade quando o fluxo é 0), e a rede residual correspondente:
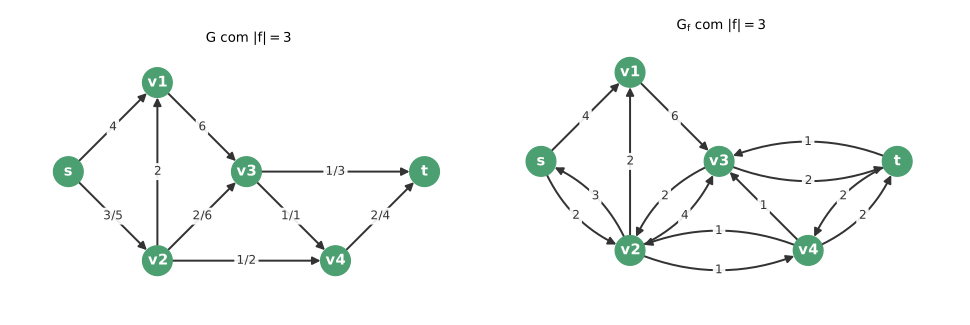
Fluxo com |f| = 3, em notação fluxo/capacidade, e a respectiva rede residual
5.9.3 Caminhos de aumento
Um caminho de aumento em uma rede residual é qualquer caminho que começa em e termina em . A menor capacidade residual ao longo do caminho (o gargalo ) indica quantas unidades de fluxo podem ser somadas a .
No exemplo anterior, o caminho tem gargalo e eleva o fluxo de para . A rede residual fica atualizada como abaixo; note que a aresta satura e deixa de aparecer em :
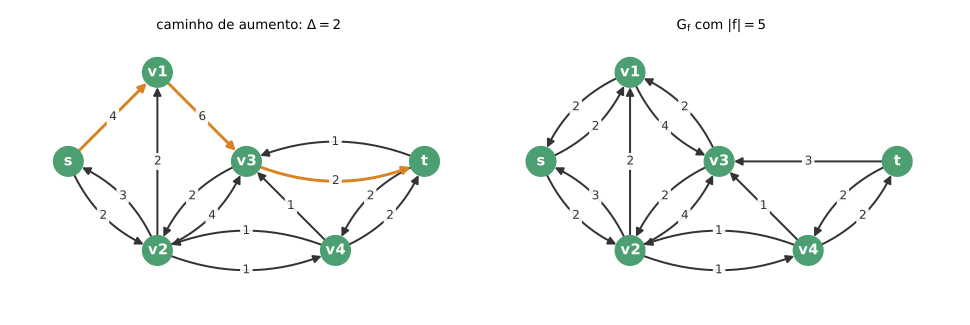
Caminho de aumento s → v1 → v3 → t destacado na rede residual e a rede residual atualizada, com |f| = 5
Importante: nem sempre os caminhos de aumento geram aumentos no fluxo de toda aresta. Considere novamente a rede residual com . O caminho usa a aresta (tracejada na figura), que não existe em : aplicá-lo equivale a desistir de enviar 1 unidade em para que uma unidade a mais possa ser enviada em . A rede residual resultante tem :
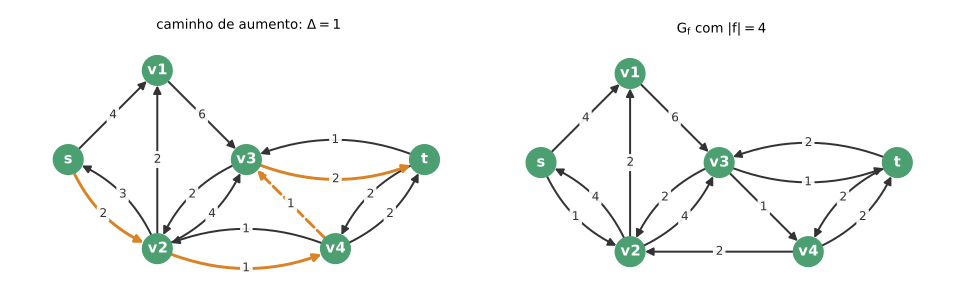
Caminho de aumento s → v2 → v4 → v3 → t, com a aresta de cancelamento (v4, v3) tracejada, e a rede residual resultante, com |f| = 4
5.9.4 Método de Ford-Fulkerson
O método de Ford-Fulkerson consiste em aumentar enquanto houver caminho de aumento:
ford-fulkerson(G, s, t)
// argumentos:
// G: rede de fluxo com vértices V e arestas E
// s: vértice fonte
// t: vértice destino
// ao final, cada aresta contém seu fluxo em e.f

  for each (u, v) in G.E
    (u, v).f = 0                      // fluxo inicial nulo
  G_f = rede residual a partir de G
  while existe caminho de aumento p em G_f de s a t
    delta = min { c_f(u, v) : (u, v) in p }
    for each (u, v) in p
      e = (u, v)
      if e in G.E
        e.f = e.f + delta
      else
        e = (v, u)
        e.f = e.f - delta
    atualize a rede residual G_f ao longo do caminho p
Quanto à complexidade, construir a rede residual custa , pois o grafo é conexo, e encontrar um caminho de aumento custa (uma busca); assim, cada iteração do laço custa . No pior caso, o fluxo aumenta de 1 em 1 até atingir o fluxo máximo, denotado . A conclusão é que o método custa, no total, .
5.9.5 Algoritmo de Edmonds-Karp
O custo pode ser ruim. Na rede abaixo, o que acontece se a aresta , de capacidade 1, for escolhida a cada passo nos caminhos de aumento? Os caminhos alternam entre e , cada um com , e são necessárias 200 iterações para atingir o fluxo máximo .
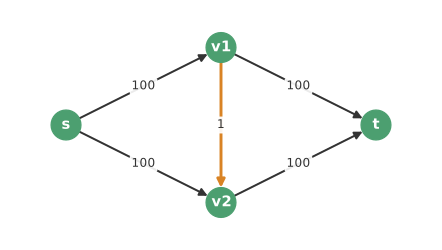
Rede em que uma escolha ruim de caminhos de aumento torna o método lento: a aresta de capacidade 1 está destacada
Como melhorar? Adicionar critérios para a escolha do caminho de aumento a cada passo, o que afeta apenas a escolha de no laço do método.
O algoritmo de Edmonds-Karp escolhe, a cada iteração, o caminho de aumento com menor quantidade de arestas (menor comprimento), encontrado por uma busca em largura na rede residual.
Quanto à complexidade: o comprimento dos caminhos mínimos nunca decresce de uma iteração para outra, pois a cada iteração uma das arestas fica à sua capacidade máxima (saturada). Se o comprimento nunca decresce, então, para cada aresta , o tamanho de um caminho mínimo que alcança não pode ultrapassar o tamanho máximo para tais caminhos, que ocorre quando não repetimos vértices (sem ciclos). Como isso vale para qualquer aresta , cada aresta fica saturada, no máximo, vezes; portanto, há no máximo iterações, pois cada uma das arestas satura vezes. Como é o custo de encontrar os caminhos e atualizar , a conclusão é .
5.9.6 Execução passo a passo
Vamos executar o algoritmo sobre o exemplo clássico do CLRS 3ed. (capítulo 26). Inicialmente, todos os fluxos são 0, de modo que a rede residual é exatamente o próprio . A figura abaixo mostra a rede residual após cada iteração; em cada painel, o caminho de aumento encontrado naquela rede residual está destacado:
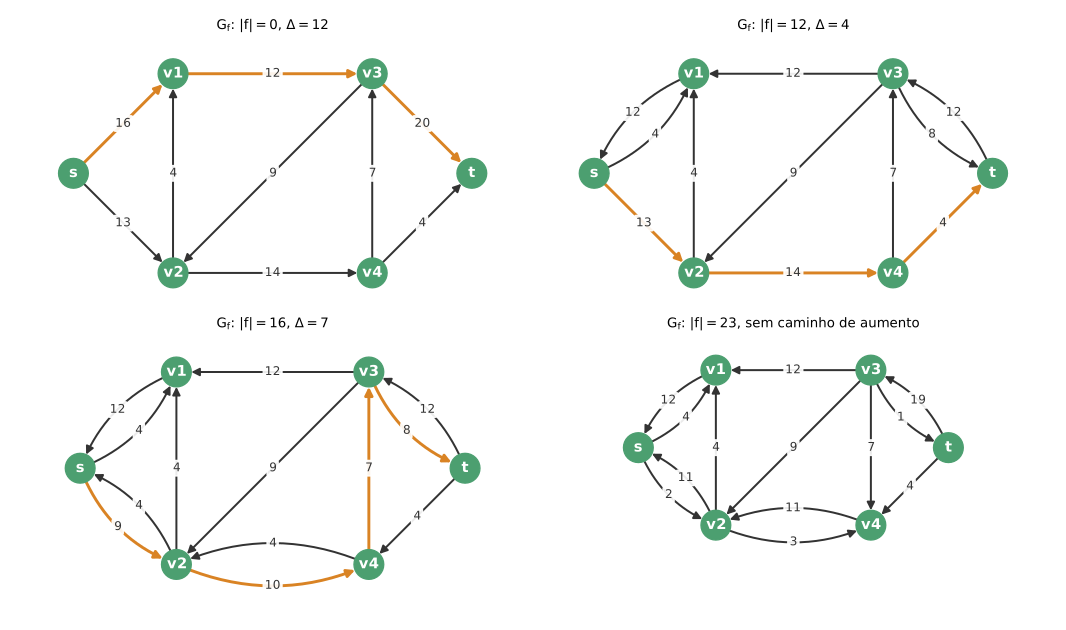
Execução passo a passo: rede residual inicial e redes residuais após cada uma das três iterações
Iteração 1: caminho , com 3 arestas e ; o fluxo vai a .
Iteração 2: caminho , com 3 arestas e ; o fluxo vai a .
Iteração 3: caminho , com 4 arestas e ; o fluxo vai a .
Após a terceira iteração, a rede residual não possui caminho de aumento, e o fluxo abaixo, com , é máximo:
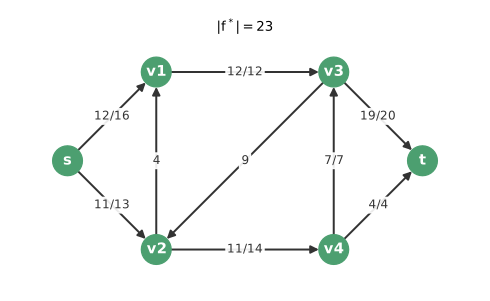
Fluxo máximo da rede de exemplo, com |f*| = 23
5.9.7 Fluxo máximo e corte mínimo
Um corte de é uma partição de , isto é, e , com e . A capacidade do corte considera apenas as arestas que vão de para :
O fluxo através do corte é o fluxo líquido de para , em que as arestas de para contam negativamente; ele é sempre igual ao valor do fluxo: .
Teorema (fluxo máximo / corte mínimo). As seguintes afirmações são equivalentes (CLRS 3ed., capítulo 26):
(A) é um fluxo máximo em ;
(B) a rede residual não possui caminho de aumento;
(C) para algum corte de .
Em particular, qualquer corte limita superiormente o valor do fluxo: .
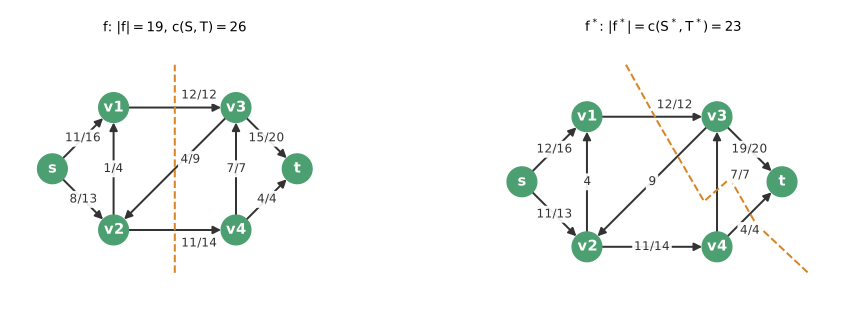
Cortes em uma rede: à esquerda, um fluxo não ótimo limitado por um corte de capacidade 26; à direita, o fluxo ótimo, que atinge o corte mínimo, de capacidade 23
Exemplo (fluxo não ótimo). No painel da esquerda, o fluxo tem e o corte tracejado separa de : as arestas e vão de para , e a aresta vai de para . Portanto, e . Como e ainda há caminhos de aumento, esse fluxo não é máximo.
Exemplo (fluxo ótimo). No painel da direita, o fluxo , com , atinge a capacidade de um corte: para e , as arestas de para são , e , de modo que . Esse é o corte mínimo da rede: o valor do fluxo máximo é exatamente a capacidade do corte mínimo.
5.10 Grafos eulerianos e hamiltonianos
Conceitos importantes: caminhos e ciclos eulerianos, teorema que argumenta que em um grafo euleriano todo vértice tem grau par, algoritmo de Fleury que constrói um ciclo euleriano.
5.10.1 Definições importantes
Percurso: coleção de vértices que são sequencialmente adjacentes
Caminho: percurso em um grafo direcionado com todas as arestas no sentido início-fim do percurso.
Percurso simples: não repete ligações.
Percurso elementar: não repete vértices.
Ciclo: percurso elementar fechado.
Circuito: caminho elementar fechado – ciclo orientado.
5.10.2 Grafos eulerianos
Teorema 5.1. Um grafo não direcionado e conexo possui um ciclo euleriano se, e somente se, todos os seus vértices tiverem grau par.
Prova: Para devemos observar que em um ciclo precisamos ter uma forma de entrar e sair de cada vértice, ou seja, pelo menos uma quantidade par de arestas incidentes a cada um deles. Para devemos fazer por indução no número de arestas. Todo grafo conexo cujos graus dos vértices forem todos ≥ 2 possui um percurso fechado: basta escolher iterativamente para cada vértice duas arestas, uma para entrada e uma para saída. Vamos considerar o percurso fechado de maior tamanho. Ao retirar as arestas desse percurso fechado do grafo, temos dois casos: ou todas as arestas foram retiradas e o percurso em questão é por si só um ciclo euleriano (percurso fechado que não repete arestas), ou sobraram algumas arestas formando uma componente também com todos os vértices de grau par – cada vértice tem seu grau diminuído de duas unidades, já que estamos retirando um percurso fechado. Se a componente restante tem vértices com grau par apenas e ela tem arestas, então novamente podemos dizer que existe um percurso fechado. Isso é um absurdo, já que poderíamos combinar esse novo percurso fechado com o percurso fechado inicial e máximo que teríamos um percurso fechado maior ainda, contradizendo a premissa. Em suma, podemos visualizar um ciclo euleriano (percurso fechado com todas as arestas) como uma decomposição disjunta das arestas em vários ciclos.
Algoritmo de Fleury
CICLO-EULERIANO-FLEURY(G(V, E))
// argumentos:
// G(V, E): grafo euleriano com vértices V e arestas E

seja s in V um vértice inicial qualquer
u = s // vértice corrente no percurso
while existirem arestas no grafo
   if d(u) == 1 // grau de u
      escolha a única aresta possível (u, v) in E
   else
      escolha (u, v) in E tal que mesmo que (u, v) seja removida,
                       s continua na mesma componente do restante das arestas
   adicione (u, v) ao percurso
   remova a aresta (u, v) do grafo
   u = v
retorne a sequência de arestas
Algoritmo de Hierholzer
O algoritmo de Hierholzer é uma alternativa ao de Fleury, oferecendo uma abordagem mais eficiente para encontrar ciclos eulerianos. Em vez de verificar se uma aresta é uma ponte a cada passo (operação custosa), Hierholzer utiliza uma pilha (stack) para explorar arestas de forma sistemática. A ideia central é seguir arestas até formar um ciclo fechado, depois retroceder e continuar de vértices que ainda possuem arestas não utilizadas.
Complexidade: O(n + m) para grafos implementados com lista de adjacência e marcação de arestas via set.
CICLO-EULERIANO-HIERHOLZER(G(V, E))
// argumentos:
// G: grafo euleriano com vértices V e lista de adjacências G.AdjList

  seja s in V um vértice inicial qualquer
  G' = copy of G
  S = stack vazio
  C = lista vazia
  push(S, s)
  while S nao-vazio
    u = top(S)
    if G'.AdjList[u] is not empty
      v = remove first edge from G'.AdjList[u]
      remove edge (v, u) from G'.AdjList[v]
      push(S, v)
    else
      pop(S)
      append(C, u)
  return reverse(C)
Análise de complexidade de Fleury vs. Hierholzer
Hierholzer: O(n + m)
Cada vértice é empilhado e desempilhado no máximo uma vez:
Cada aresta é removida da lista de adjacência exatamente uma vez:
Operações
push,pop,appendno topo da pilha sãoComplexidade total:
Comparação com Fleury: O(n + m) vs O(m²)
O algoritmo de Fleury possui complexidade , que em grafos densos reduz-se a . A razão reside na verificação de ponte a cada iteração: para evitar remover uma aresta que desconecta o grafo, Fleury deve testar se a aresta é crítica (uma operação que requer DFS ou BFS, custando ). Como Fleury executa iterações, o custo total é . Hierholzer evita completamente essa verificação ao remover arestas conforme as utiliza, eliminando a possibilidade de ficar preso.
Implementação eficiente de remoção em :
Para remover arestas da lista de adjacência em tempo amortizado (sem busca linear), use uma das estratégias:
Ponteiros bidireciais (forward/backward links): Cada aresta armazena referências para sua posição em
G.AdjList[u]e sua aresta reversa emG.AdjList[v]. Remover é então atualizar ponteiros (similar a remoção de nó em lista ligada duplamente).Índices com marcação: Manter um array paralelo
marked[]que marca arestas como removidas. Ao iterarG.AdjList[u], pule arestas marcadas. A cópia inicial custa , e cada remoção é .
Algoritmos para o problema do carteiro chinês
Se trata de um problema de otimização associado ao problema de encontrar ciclos eulerianos. A premissa principal é que se tenha um grafo ponderado, não necessariamente euleriano, com o objetivo de encontrar uma trilha fechada de menor custo. Existe uma sutileza aqui: se o grafo não é euleriano precisamos “repetir” arestas para completar a trilha fechada e, por isso, repetindo o custo daquela aresta específica. A ideia é ser capaz de encontrar essa trilha de forma a minimizar o custo total do passeio.
CARTEIRO-CHINES(G(V, E))
// argumentos:
// G(V, E): grafo com vértices V e arestas E

if G nao-euleriano
   seja I o subconjunto de V dos vertices de grau impar
   for each u in I
      descubra os caminhos minimos d_uv a partir de u // usando Dijkstra, por exemplo
      d_uu = infinity
   P = pares de vertices u, v in I cuja soma das distancias d_uv seja minima // Algoritmo hungaro
   for each (u, v) in P
      adicionar aresta artificial (u, v) em G com custo d_uv
C = CICLO-EULERIANO-FLEURY(G(V, E))
for each aresta artificial (u, v) in C
   substitua em C a aresta (u, v) pelo caminho minimo u -> v
retorne C
CARTEIRO-CHINES-DIRECIONADO(G(V, E))
// argumentos:
// G(V, E): grafo direcionado com vértices V e arestas E
if G nao-euleriano
seja S o subconjunto de V dos vertices u tal que d+(u) - d-(u) > 0
seja T o subconjunto de V dos vertices u tal que d+(u) - d-(u) < 0
for each u in S
descubra os caminhos minimos d_uv a partir de u para todo v in T // Algoritmo Dijkstra
d_uu = infinity
S' = REPLICA-VERTICES(S) // w^(u) denota uma copia de u in S
T' = REPLICA-VERTICES(T) // w^(u) denota uma copia de u in T
PREENCHE-DISTANCIAS-REPLICAS(S', T', S, T)
P = pares u in (S union S'), v in (T union T') cuja soma das distancias d_uv seja minima // Algoritmo hungaro
for each (w, z) in P
if w e replica w^(r) entao u = r senao u = w
if z e replica z^(r) entao v = r senao v = z
adicionar aresta artificial (u, v) em G com custo d_uv
C = CICLO-EULERIANO-FLEURY(G(V, E))
for each aresta artificial (u, v) in C
substitua em C a aresta (u, v) pelo caminho minimo u -> v
retorne CREPLICA-VERTICES(V)
// argumentos:
// V: conjunto de vértices
V' = {}
for each u in V
for i = 2 to |d+(u) - d-(u)|
seja w^(u) uma copia de u
V' = V' union {w^(u)}
retorne V'PREENCHE-DISTANCIAS-REPLICAS(S', T', S, T)
// argumentos:
// S', T': conjuntos de vértices replicados
// S, T: conjuntos de vértices originais
for each w^(u) in S'
for each z^(v) in T'
d_{w^(u)z^(v)} = d_uv
for each w^(u) in S'
for each v in T
d_{w^(u)v} = d_uv
for each u in S
for each z^(v) in T'
d_{uz^(v)} = d_uvAlgumas características importantes do algoritmo que resolve o problema do carteiro chinês:
Se trata de um algoritmo de complexidade polinomial: algoritmo húngaro e chamadas do algoritmo de Djkstra continuam sendo polinomiais.
Quando organizamos os vértices de grau ímpar em um grafo não euleriano em pares, isso sempre é seguro já que para qualquer grafo devemos ter uma quantidade par de vértices com grau ímpar: senão a soma dos graus não seria par e sabemos que isso é verdade.
Se um grafo é euleriano já sabemos exatamente qual é o custo mínimo da instância: exatamente a soma dos pesos de cada aresta.
Se um grafo não é euleriano, será inevitável passar por algumas arestas mais de uma vez e isso é capturado pelas arestas artificiais adicionadas: passar por uma aresta artificial (u, v) no percurso é equivalente a um percurso de mesmo custo que usa apenas arestas do grafo original: .
5.10.3 Grafos hamiltonianos
Um ciclo hamiltoniano é um ciclo que visita cada vértice do grafo exatamente uma vez, retornando ao vértice de partida. Diferentemente dos ciclos eulerianos, para os quais existe uma caracterização simples (teorema 5.1), não se conhece condição necessária e suficiente simples para a existência de ciclos hamiltonianos: o problema de decisão é NP-completo. Uma variante de otimização é o problema do caixeiro viajante (PCV): dado um grafo ponderado, encontrar o ciclo hamiltoniano de menor custo total. No PCV assume-se que o grafo é completo: toda aresta que não existia originalmente é acrescentada com custo infinito (ou suficientemente grande), de modo que um ciclo de custo mínimo sempre evita tais arestas, salvo quando o grafo original não possui ciclo hamiltoniano algum.
Uma abordagem exata para o PCV é a busca por backtracking: a partir de um vértice inicial fixo , o algoritmo estende recursivamente um caminho elementar (sem repetição de vértices), mantendo o custo do melhor ciclo completo encontrado até o momento. Quando o caminho corrente contém todos os vértices, ele é fechado com a aresta de volta a , formando um ciclo candidato a solução ótima. Ao retornar de cada chamada recursiva, a marcação do vértice é desfeita, permitindo que ele participe de outros caminhos.
pcv-backtracking(G, u, s, visited, d)
// argumentos:
// G: grafo ponderado completo com vértices V e listas de adjacências G.AdjList,
//    com n = |V| e w(u, v) o peso da aresta (u, v)
//    (arestas inexistentes no grafo original têm w = infinity)
// u: vértice corrente do caminho sendo construído
// s: vértice inicial do ciclo (fixo)
// visited: vetor booleano de tamanho n, inicialmente todo false
// d: quantidade de arestas no caminho corrente de s até u

  visited[u] = true
  if d == n - 1
     visited[u] = false
     return (w(u, s), [s])
  mincost = infinity
  bestpath = NIL
  for each v in G.AdjList[u]
     if visited[v] == false
        (cost, path) = pcv-backtracking(G, v, s, visited, d + 1)
        if cost + w(u, v) < mincost
           mincost = cost + w(u, v)
           bestpath = [v] concatenado com path
  visited[u] = false
  return (mincost, bestpath)
Como o grafo é completo, todo caminho elementar com vértices pode ser fechado em um ciclo: arestas artificiais contribuem com custo infinito e naturalmente nunca aparecem na solução de custo mínimo, a menos que o grafo original não admita ciclo hamiltoniano. Assim, não é preciso testar a existência da aresta de fechamento nem a validade do caminho retornado: as comparações de custo fazem esse papel.
A chamada inicial é pcv-backtracking(G, s, s, visited, 0) para um vértice qualquer, com visited[u] = false para todo in . O retorno é o par (custo, caminho) do ciclo hamiltoniano mínimo; se o custo for infinito, o grafo original não possui ciclo hamiltoniano.
Exemplo de execução
Considere o grafo completo de 4 vértices abaixo, com os pesos indicados nas arestas:
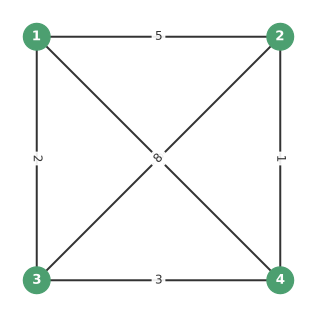
Grafo completo de 4 vértices com pesos nas arestas
A figura a seguir mostra a árvore de recursão do algoritmo a partir do vértice , explorando os vizinhos em ordem crescente de rótulo. Cada nível corresponde a uma profundidade do caminho sendo construído, e as arestas da árvore são anotadas com o peso da aresta percorrida no grafo. As folhas representam o fechamento do ciclo com a aresta de volta a 1, com o custo total anotado abaixo de cada uma. Os vértices em vermelho formam o ciclo de custo mínimo: , com custo . Note que o primeiro ramo explorado pela busca (, custo 24) não é o ótimo, que só é descoberto no ramo seguinte.
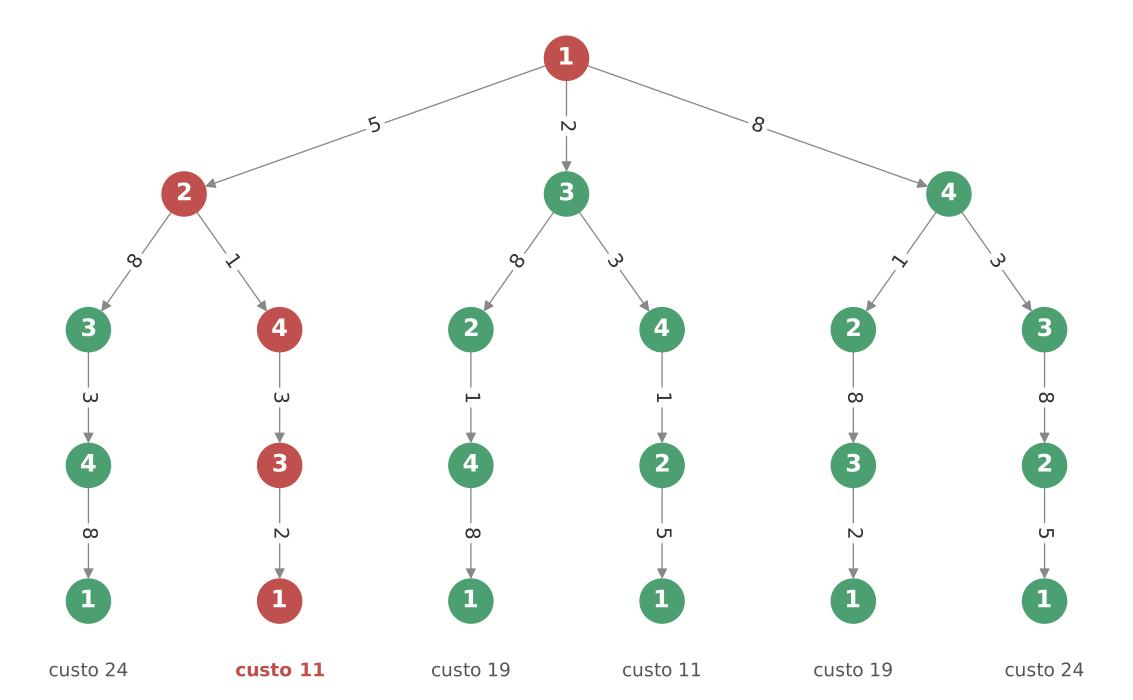
Árvore de recursão do pcv-backtracking
O segundo exemplo ilustra o papel das arestas artificiais. Considere o grafo de 5 vértices abaixo, que não é completo (não existem as arestas , e ):
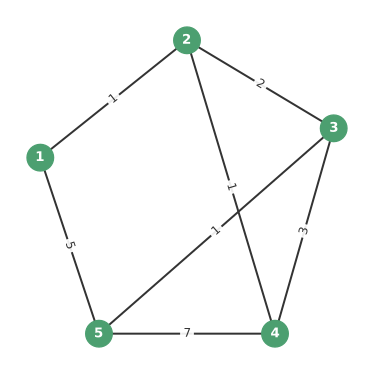
Grafo de 5 vértices não completo com pesos nas arestas
Como o PCV assume o grafo completo, o algoritmo explora normalmente os vértices ausentes como vizinhos, mas qualquer ramo que usa uma aresta artificial acumula custo infinito. Na árvore de recursão abaixo, esses ramos aparecem anotados com : das permutações, apenas 4 correspondem a ciclos com custo finito no grafo original. Os vértices em vermelho indicam o ciclo de custo mínimo, , com custo . O primeiro ramo completamente explorado, , tem custo 18.
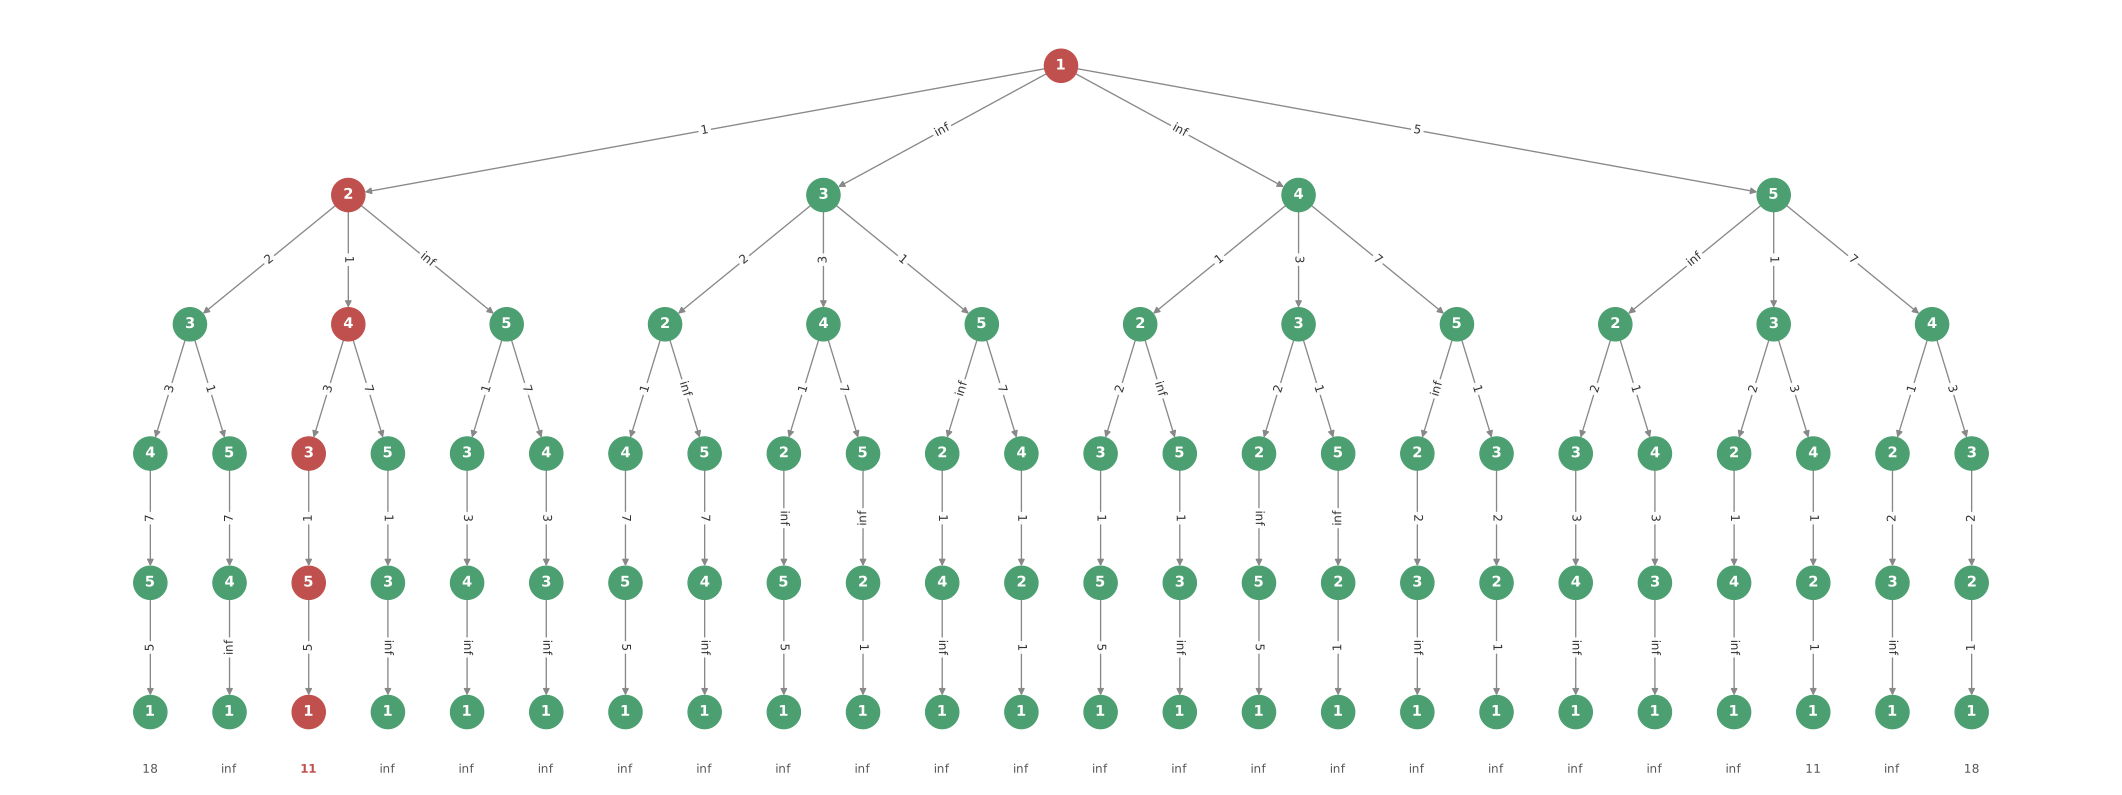
Árvore de recursão do pcv-backtracking para grafo não completo
Complexidade: no pior caso, a partir do vértice inicial o algoritmo explora todas as permutações dos vértices restantes, isto é, caminhos candidatos. Como cada caminho é processado em tempo polinomial, a complexidade total é no pior caso. Na prática, ramos que acumulam arestas de custo infinito deixam de ser competitivos cedo nas comparações, mas o crescimento fatorial inviabiliza instâncias grandes, o que motiva o uso de podas (branch and bound), programação dinâmica ou heurísticas aproximadas.
5.10.4 PCV com podas (branch and bound)
O backtracking puro da seção anterior só compara custos de ciclos completos: um ramo que já acumulou um custo parcial maior que o melhor ciclo conhecido continua sendo explorado até o fim. A versão com podas elimina esse desperdício com duas mudanças:
o algoritmo passa a carregar o custo parcial do caminho construído até o momento;
o melhor custo conhecido é mantido em uma variável global , compartilhada por todas as chamadas: sempre que um ciclo completo melhor é encontrado, é atualizado imediatamente, e qualquer chamada cujo custo parcial já atingiu é interrompida na hora (poda), pois nenhuma extensão desse caminho pode melhorar a solução (os pesos são não negativos).
best = infinity    // variável global: custo do melhor ciclo conhecido
bestcycle = NIL    // variável global: melhor ciclo conhecido

pcv-backtracking-poda(G, u, s, visited, d, c)
// argumentos:
// G: grafo ponderado completo com vértices V e listas de adjacências G.AdjList,
//    com n = |V| e w(u, v) o peso da aresta (u, v)
//    (arestas inexistentes no grafo original têm w = infinity)
// u: vértice corrente do caminho sendo construído
// s: vértice inicial do ciclo (fixo)
// visited: vetor booleano de tamanho n, inicialmente todo false
// d: quantidade de arestas no caminho corrente de s até u
// c: custo acumulado do caminho de s até u

  visited[u] = true
  if d == n - 1
     if c + w(u, s) < best
        best = c + w(u, s)
        bestcycle = caminho de s até u concatenado com [s]  // recuperável com vetor de predecessores
     visited[u] = false
     return
  for each v in G.AdjList[u]
     if visited[v] == false
        if c + w(u, v) < best    // poda: ramo não pode melhorar o melhor ciclo
           pcv-backtracking-poda(G, v, s, visited, d + 1, c + w(u, v))
  visited[u] = false
A chamada inicial é pcv-backtracking-poda(G, s, s, visited, 0, 0); ao final, best e bestcycle guardam a solução (com best = infinity se não houver ciclo hamiltoniano no grafo original). Dois pontos merecem atenção:
A poda só é segura porque os pesos são não negativos: o custo parcial é um limitante inferior (bound) para qualquer extensão do caminho corrente. É exatamente a ideia do branch and bound: funciona como a melhor solução incumbente e o custo parcial como o limitante do ramo.
A eficácia da poda depende da ordem de exploração: quanto mais cedo um ciclo bom é encontrado, mais ramos são cortados. Por isso, em vez de percorrer os vizinhos em ordem arbitrária, é comum ordená-los por peso crescente da aresta , o que tende a achar boas soluções nas primeiras ramificações.
No pior caso nenhuma poda ocorre e a complexidade permanece , mas na prática o corte de ramos reduz drasticamente o número de caminhos explorados. O best também pode começar inicializado com o custo de uma solução heurística qualquer (por exemplo, vizinho mais próximo), podando desde a primeira chamada.
Exemplo de execução com podas
A seguir o mesmo exemplo anterior, mas com o algoritmo que usa podas. O pior caso do algoritmo continua sendo percorrer todos os caminhos possíveis.
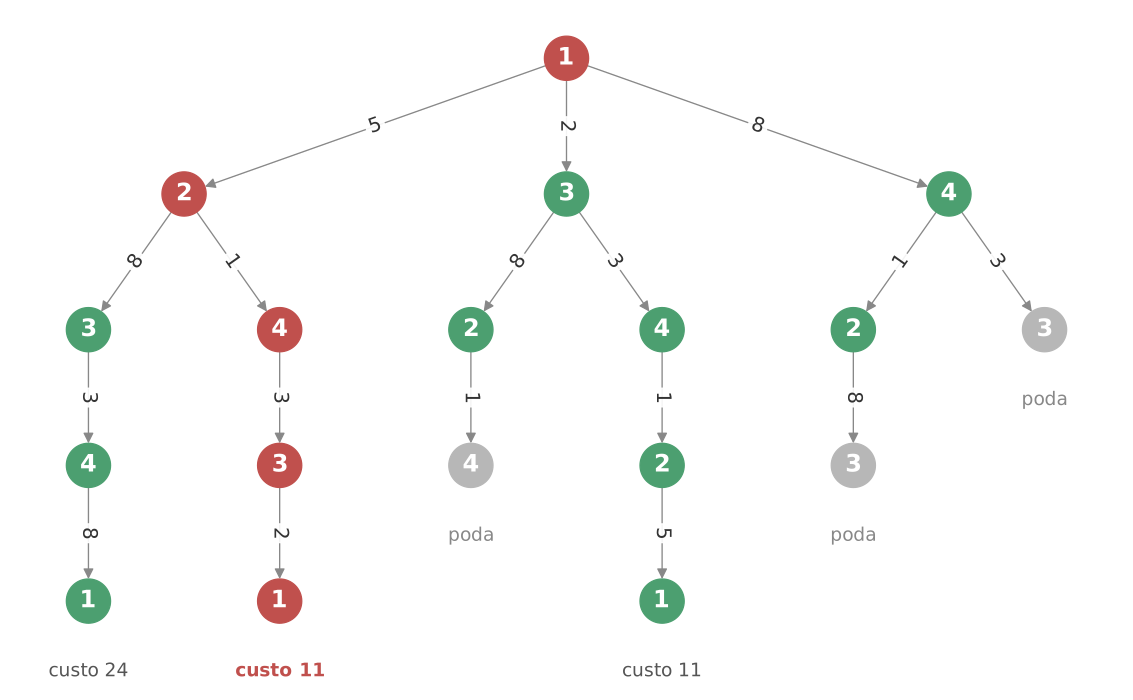
Árvore de recursão do pcv-backtracking com podas
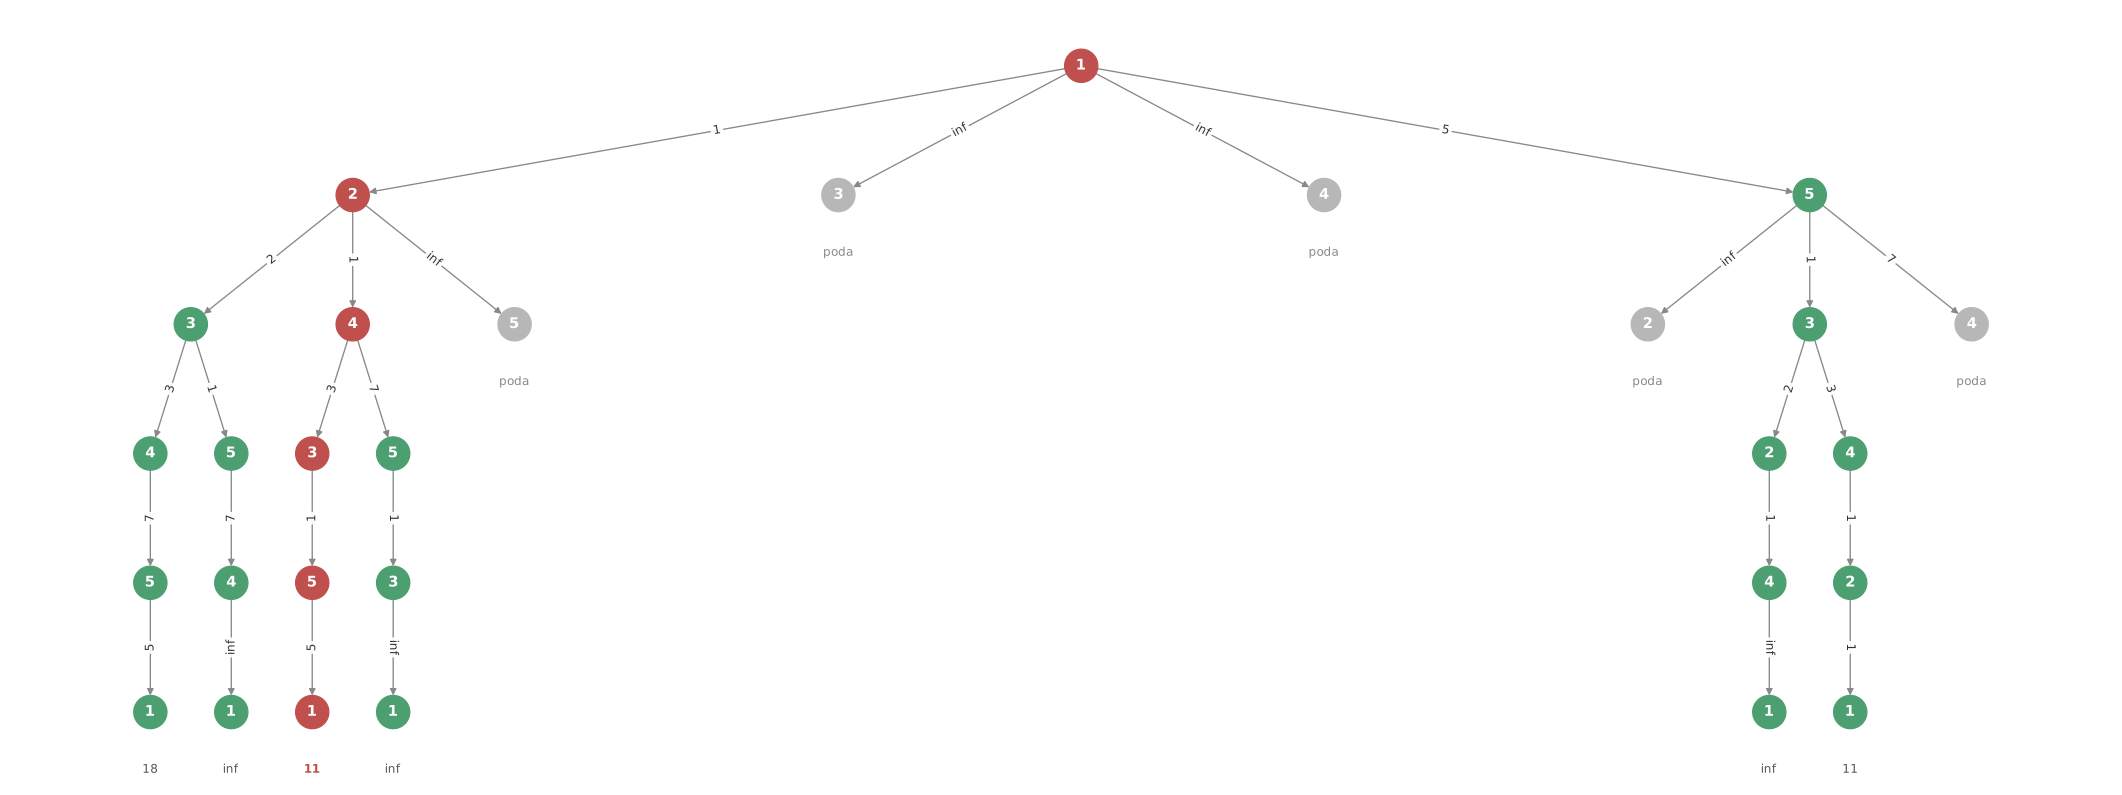
Árvore de recursão do pcv-backtracking com podas para grafo não completo
5.10.5 Heurísticas para o PCV
Os métodos exatos vistos até aqui têm complexidade fatorial no pior caso, o que os inviabiliza para instâncias grandes. Uma alternativa prática são as heurísticas construtivas: algoritmos polinomiais que constroem um ciclo hamiltoniano de forma incremental, fazendo escolhas localmente boas, sem garantia de otimalidade. A seguir, três heurísticas clássicas para o PCV, sendo que a proposta de implementação/pseudocódigo fica a cargo do leitor:
Vizinho mais próximo. começamos de um vértice inicial qualquer e, a cada passo, o caminho é estendido para o vértice ainda não visitado mais próximo do vértice corrente. Quando todos os vértices tiverem sido visitados, o ciclo é fechado com a aresta de volta ao vértice inicial. A ideia captura a intuição de que deslocamentos curtos tendem a compor um ciclo barato, mas a escolha míope pode deixar vértices distantes para o final, quando não há mais alternativa barata para inseri-los. A complexidade é (tem como melhorar uma implementação quadrática?).
Inserção mais próxima. ao invés de estender um caminho por uma extremidade, a heurística mantém um ciclo parcial que cresce por inserções. Inicia-se com dois vértices e o ciclo entre eles (ida e volta pela mesma aresta). Enquanto existirem vértices fora do ciclo, escolhe-se o par (vértice não visitado, posição entre dois vértices consecutivos do ciclo corrente) cuja inserção gere o menor custo total do ciclo, isto é, o vértice e a aresta do ciclo que minimizam o acréscimo . O vértice escolhido é inserido entre os dois vértices da posição escolhida, e o processo se repete até que o ciclo contenha todos os vértices. A inserção tende a acomodar cada vértice onde ele “menos atrapalha” o ciclo, o que costuma produzir soluções melhores que o vizinho mais próximo, ao custo de uma complexidade maior, .
Escolha gulosa de arestas. esta o constrói aresta a aresta. As arestas são consideradas em ordem crescente de peso, e cada aresta é incorporada à solução desde que duas restrições sejam respeitadas: (1) a aresta não pode fechar um ciclo que não contenha todos os vértices (nenhum ciclo prematuro); (2) a aresta não pode dar grau maior que 2 a nenhum vértice (em um ciclo hamiltoniano, todo vértice incide em exatamente duas arestas). As arestas rejeitadas são descartadas, e o processo termina quando arestas tiverem sido selecionadas, formando o ciclo. A semelhança com o algoritmo de Kruskal não é coincidência: a ideia é a mesma, mas enquanto Kruskal proíbe qualquer ciclo (buscando uma árvore), aqui apenas ciclos prematuros e graus excessivos são proibidos, pois o objetivo é justamente terminar com um único ciclo. Com arestas pré-ordenadas, a seleção custa e a verificação de ciclos pode ser feita com uma estrutura de conjuntos disjuntos (union-find), como em Kruskal.
As três heurísticas são rápidas e fáceis de implementar, mas podem produzir soluções arbitrariamente distantes do ótimo em instâncias adversas. Na prática, elas são úteis tanto como soluções finais aproximadas quanto como ponto de partida: o custo de um ciclo heurístico inicializa a variável best do branch and bound (seção 5.10.4), permitindo podas desde a primeira chamada recursiva.
Exemplo de execução: grafo completo de 4 vértices
O primeiro exemplo é o grafo completo de 4 vértices da seção 5.10.3, cujo ciclo ótimo é (custo 11). Os passos das três heurísticas, partindo do vértice 1:
Vizinho mais próximo
| Decisão | Caminho parcial |
|---|---|
| aresta , peso 2 | |
| aresta , peso 3 | |
| aresta , peso 1 | |
| fechamento com , peso 5 | (custo 11) |
Inserção mais próxima
| Decisão | Ciclo parcial |
|---|---|
| ciclo inicial com os dois vértices mais próximos: , peso 2 | (custo 4) |
| insere 4 entre 1 e 3, acréscimo | (custo 13) |
| insere 2 entre 1 e 4, acréscimo | (custo 11) |
Escolha gulosa de arestas
| Decisão | Caminho parcial |
|---|---|
| aresta , peso 1 | |
| aresta , peso 2 | , |
| aresta , peso 3 | |
| aresta , peso 5 | (custo 11) |
No grafo completo, as três heurísticas encontram o ciclo ótimo. Na inserção mais próxima, note o acréscimo negativo do segundo passo: inserir 2 entre 1 e 4 troca a aresta cara , de peso 8, pelas baratas e .
Exemplo de execução: grafo não completo de 5 vértices
O segundo exemplo é o grafo de 5 vértices da seção 5.10.3 (sem as arestas , e ), cujo ciclo ótimo é (custo 11):
Vizinho mais próximo
| Decisão | Caminho parcial |
|---|---|
| aresta , peso 1 | |
| aresta , peso 1 | |
| aresta , peso 3 | |
| aresta , peso 1 | |
| fechamento com , peso 5 | (custo 11) |
Inserção mais próxima
| Decisão | Ciclo parcial |
|---|---|
| ciclo inicial com os dois vértices mais próximos: , peso 1 | (custo 2) |
| insere 3 entre 1 e 2, acréscimo (usa a aresta artificial ) | (custo ) |
| insere 5 entre 1 e 3, eliminando a artificial | (custo 9) |
| insere 4 entre 3 e 2, acréscimo | (custo 11) |
Escolha gulosa de arestas
| Decisão | Caminho parcial |
|---|---|
| aresta , peso 1 | |
| aresta , peso 1 | |
| aresta , peso 1 | , |
| rejeita , peso 2: grau de 2 ficaria maior que 2 | , |
| aresta , peso 3 | |
| aresta , peso 5 | (custo 11) |
5.11 Isomorfismo
5.11.1 Isomorfismo de grafos
A palavra vem do grego: isos (igual) e morphe (forma). Dois grafos isomorfos têm a mesma estrutura, diferindo apenas nos nomes dos vértices e no desenho.
Dois grafos e são isomorfos se existe uma função bijetora tal que:
são adjacentes em se, e somente se, e são adjacentes em .
Para multigrafos (como no exemplo 2), também deve preservar a multiplicidade das arestas entre cada par de vértices.
Para verificar um isomorfismo dado, basta checar que é bijetora e que . Como é bijetora, isso equivale a verificar que e que toda aresta de é levada em uma aresta de .
Exemplo 1: ciclo e pentagrama
é o ciclo (pentágono) com vértices e arestas , com . é o pentagrama com vértices e arestas .
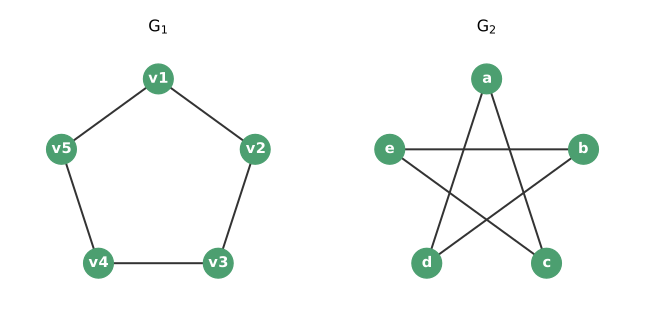
Exemplo 1 de isomorfismo: pentágono e pentagrama
Mapeamento: , , , , .
Verificação das arestas de : , , , , . Todas são arestas de , e ambos têm 5 arestas.
Exemplo 2: multigrafos
O grafo da esquerda tem vértices . O vértice é adjacente a todos os demais, formam um triângulo e e são ligados por duas arestas paralelas. O grafo da direita tem vértices , com adjacente a todos os demais, triângulo e duas arestas paralelas entre e .
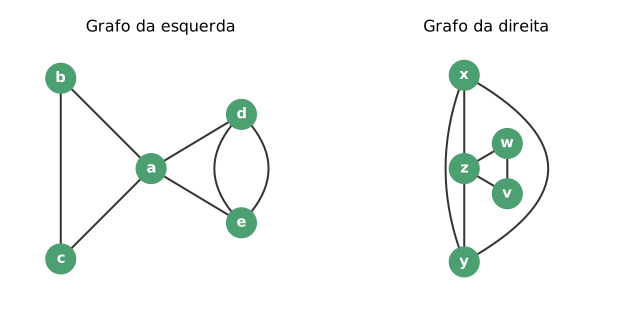
Exemplo 2 de isomorfismo: multigrafos
Função bijetora: , , , , . As arestas vão em , as arestas vão em e as duas arestas vão nas duas arestas .
Exemplo 3: o grafo do cubo
À esquerda, o cubo é desenhado com um quadrado externo e um quadrado interno (ambos em sentido horário), ligados pelas arestas . À direita, o mesmo grafo é desenhado com os quadrados lado a lado.
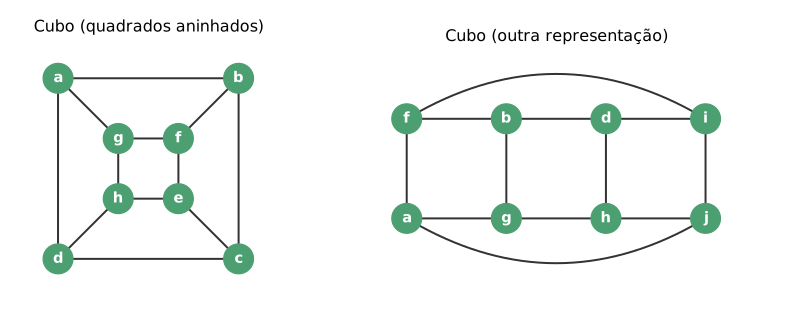
Exemplo 3 de isomorfismo: duas representações do cubo
Função bijetora: , , , , , , , .
As 12 arestas do grafo da esquerda são levadas em:
| aresta em | imagem em |
|---|---|
Esse conjunto é exatamente o conjunto de arestas do grafo da direita (dois quadrados e , ligados por ), o que confirma o isomorfismo.
Invariantes de isomorfismo
Se e são isomorfos, então ambos satisfazem simultaneamente:
mesmo número de vértices, ;
mesmo número de arestas, ;
mesma sequência de graus (mesma quantidade de vértices de grau , para todo );
mesma quantidade de ciclos de cada tamanho ;
mesma conectividade (ambos conexos, ou o mesmo número de componentes conexas);
existência (ou ausência) de circuito euleriano e de ciclo hamiltoniano;
para todo subgrafo , existe um subgrafo de isomorfo a .
Essas propriedades são condições necessárias, mas não suficientes. Se alguma delas falha, os grafos não são isomorfos. Se todas as testadas passam, nada se conclui.
5.11.2 Algoritmo de força bruta
Este algoritmo é para grafos simples e não direcionados (sem laços, sem arestas paralelas e sem orientação). Para esses grafos, com vértices numerados , testamos todas as bijeções (as permutações). Os invariantes mais baratos (números de vértices e de arestas, sequência de graus) servem de filtro inicial.
Para uma bijeção fixada (a rotina valid-iso confere explicitamente que é injetora e que suas imagens estão em ), basta verificar que toda aresta de é levada em uma aresta de . Como , leva as arestas de em arestas distintas de e, portanto, em todas elas. Sem a igualdade do número de arestas, essa verificação aceitaria um subgrafo de como se fosse isomorfo a (por exemplo, um grafo sem arestas e ).
graph-iso(G1, G2)
// argumentos:
// G1: grafo simples e não direcionado com vértices 1..n e arestas E1
// G2: grafo simples e não direcionado com vértices 1..n e arestas E2

  if |G1.V| != |G2.V| or |G1.E| != |G2.E|
    return NIL
  if degree-sequence(G1) != degree-sequence(G2)
    return NIL
  for each permutation f of 1..n
    if valid-iso(G1, G2, f)
      return f
  return NIL

valid-iso(G1, G2, f)
// argumentos:
// G1, G2: grafos simples e não direcionados, com o mesmo número de vértices e de arestas
// f: mapeamento de G1.V em G2.V, com f[u] sendo a imagem de u

  // f deve ser bijetora: cada vértice de G2 é imagem de exatamente um vértice de G1
  for each x in G2.V
    used[x] = false
  for each u in G1.V
    if f[u] not in G2.V or used[f[u]]
      return false
    used[f[u]] = true
  // adjacências: toda aresta de G1 deve ser levada em uma aresta de G2
  for each u in G1.V
    for each v in G1.AdjList[u]
      if f[v] not in G2.AdjList[f[u]]
        return false
  return true
Aqui degree-sequence(G) devolve os graus dos vértices de em ordem não crescente.
No pior caso, são testadas permutações, cada uma em tempo se o teste de pertinência a G2.AdjList for feito em tempo constante (por exemplo, consultando a matriz de adjacências de ), totalizando . Não se conhece algoritmo polinomial para o problema em geral. Na prática, algoritmos como VF2, VF2++ e nauty podam a árvore de busca usando invariantes locais a cada passo.
5.11.3 Invariantes não bastam: prisma triangular e 
Considere o prisma triangular (dois triângulos e ligados pelas arestas ) e o grafo bipartido completo (todo vértice de adjacente a todo vértice de ).
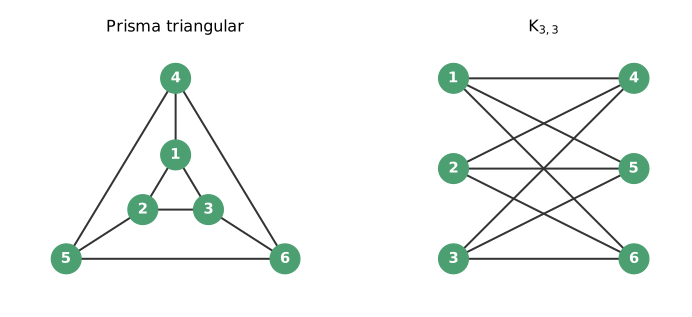
Prisma triangular e K3,3
| Invariante | (prisma) | () | Igual? |
|---|---|---|---|
| Vértices | 6 | 6 | sim |
| Arestas | 9 | 9 | sim |
| Sequência de graus | sim | ||
| Conectividade | conexo | conexo | sim |
| Ciclo hamiltoniano | sim, | sim, | sim |
| Ciclos de tamanho 4 | sim | sim | sim |
| Ciclos de tamanho 3 | sim, | não | não |
| Planaridade | planar | não planar | não |
Todos os invariantes básicos coincidem, mas os grafos não são isomorfos: é bipartido, logo só tem ciclos de tamanho par e nenhum triângulo, enquanto tem o triângulo . Isso viola o invariante 4 (e o 7, pois o triângulo é um subgrafo de sem correspondente em ).
Há ainda uma diferença mais profunda: pode ser desenhado no plano sem cruzamento de arestas (é planar), enquanto não pode. Esse é um dos grafos proibidos do teorema de Kuratowski, assunto da próxima seção.
Aplicação: moléculas como grafos. Uma molécula é naturalmente um grafo: átomos são vértices (rotulados pelo elemento) e ligações químicas são arestas; duas estruturas representam a mesma molécula se, e somente se, seus grafos moleculares são isomorfos. Bancos de dados químicos decidem isso em escala de milhões de compostos: no ChEMBL, do EMBL-EBI, um banco curado de moléculas bioativas com propriedades de fármacos, cada composto recebe uma representação canônica (como o InChI), e a busca por identidade se reduz a comparar essas representações. A busca por estrutura que orienta o desenvolvimento de fármacos é uma variação ainda mais geral do problema desta seção: encontrar todas as moléculas que contêm um dado esqueleto químico (por exemplo, um anel benzênico) é o isomorfismo de subgrafos, em que queremos saber quais grafos do banco contêm o grafo de consulta.
5.12 Planaridade
Em muitas aplicações, o cruzamento de arestas tem algum custo ou relevância (construção de circuitos impressos, desenho de grafos, mapas). Um grafo é planar se pode ser representado no plano sem nenhum cruzamento de arestas. Planaridade é uma propriedade do grafo, não do desenho: um mesmo grafo planar pode ter desenhos com cruzamentos.
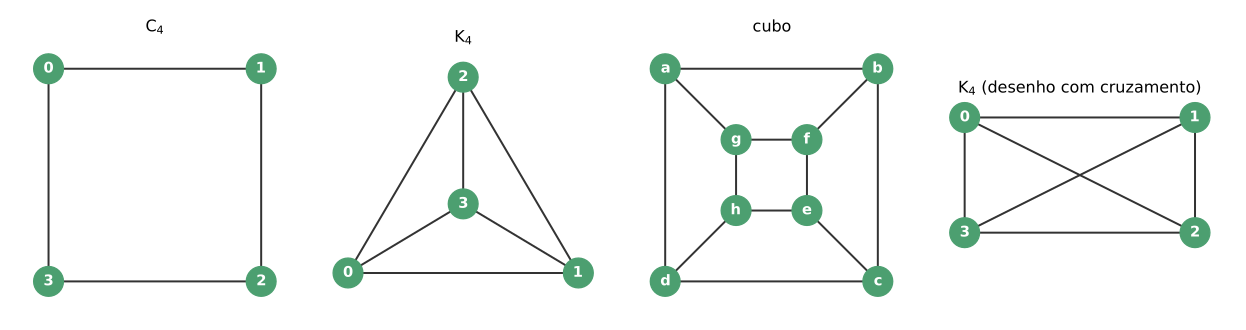
Exemplos de grafos planares
Os quatro desenhos acima mostram grafos planares: o ciclo , o grafo completo , o cubo e novamente desenhado com um cruzamento (basta redesenhá-lo sem cruzamentos, como no segundo painel).
O exemplo clássico de grafo que não é planar é o problema das três casas e três serviços (gás, água e energia): é possível ligar cada casa a cada serviço sem que as ligações se cruzem? Isso equivale a desenhar sem cruzamentos.
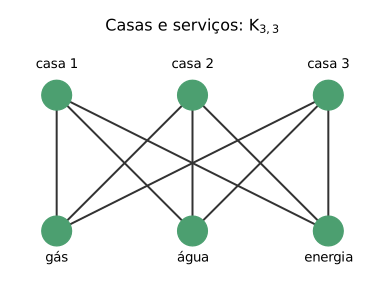
Problema das casas e serviços
Para praticar a intuição, o jogo Planarity, de Jason Davies, apresenta grafos planares desenhados com cruzamentos e pede que o jogador arraste os vértices até que nenhuma aresta se cruze. Ele também oferece variantes em que o grafo é desenhado no cilindro, na faixa de Möbius, no toro e na garrafa de Klein.
5.12.1 Faces e fórmula de Euler
Um desenho planar divide o plano em regiões chamadas faces, incluindo a face externa (ilimitada). No cubo, há 6 faces: a interna (1), as quatro laterais (2 a 5) e a externa (6).
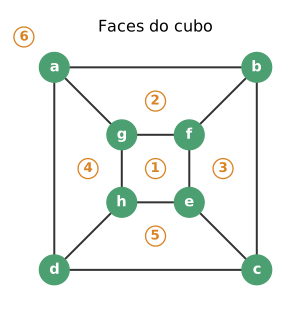
Faces do cubo
Teorema de Euler. Se é um grafo planar conexo com vértices, arestas e faces, então
No cubo, .
Exemplo. Se um grafo planar conexo possui 30 vértices, todos de grau 3, quantas faces ele tem? Como a soma dos graus é , temos . Pela fórmula de Euler, , logo .
5.12.2 Teoremas sobre grafos planares
Teorema 1. Se é um grafo planar simples com vértices e arestas, então .
Ideia da prova (para conexo). Em um grafo simples com , cada face é delimitada por pelo menos 3 arestas, e cada aresta delimita no máximo 2 faces. Logo . Substituindo pela fórmula de Euler, obtemos , ou seja, .
Exemplos:
Cubo: , .
: , . A condição é satisfeita, mas não é planar. O teorema fornece apenas uma condição necessária.
: , . A condição falha, logo não é planar.
Teorema 2. Se é um grafo planar simples, então contém um vértice com .
Ideia da prova. Se todos os vértices tivessem grau pelo menos 6, teríamos , isto é, , contradizendo o teorema 1. Novamente, satisfaz a conclusão (todos os graus são 3) e não é planar.
Teorema 3. não é planar.
Ideia da prova. é bipartido, logo não tem triângulos, e toda face é delimitada por pelo menos 4 arestas. Então , e a fórmula de Euler dá , ou seja, . Mas tem 9 arestas.
Teorema 4. não é planar. Isso decorre do teorema 1, como visto acima.
5.12.3 Teorema de Kuratowski
Uma subdivisão elementar de um grafo troca uma aresta pelas arestas e , onde é um novo vértice. Em outras palavras, o caminho passa a ser .
Dois grafos e são homeomorfos se podem ser obtidos a partir de um mesmo grafo por sucessivas subdivisões elementares. Em particular, um grafo e uma subdivisão dele são homeomorfos.
Teorema de Kuratowski. Um grafo é planar se, e somente se, não contém subgrafo homeomorfo a ou a .
Exemplo 1: subgrafo homeomorfo a . O grafo abaixo tem os vértices , o caminho e os vértices adicionais (em cinza), ligados por , , e . Removendo , obtemos o subgrafo , que é em com a aresta subdividida pelos vértices . Suavizando os vértices de grau 2 (, e ), recuperamos .
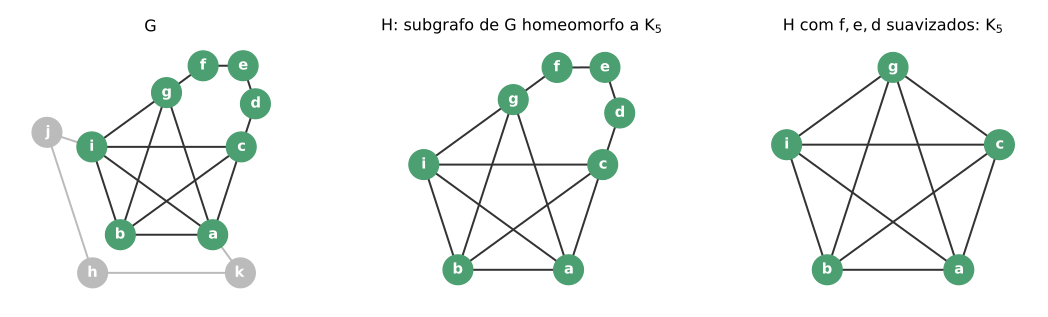
Subgrafo homeomorfo a K5
Como contém um subgrafo homeomorfo a , não é planar.
Exemplo 2: subgrafo homeomorfo a . O grafo abaixo, desenhado em formato triangular, tem arestas entre cada vértice de e cada vértice de . Redesenhado com as duas partições em linhas, vemos que é exatamente (e, portanto, isomorfo a ele). não é planar.
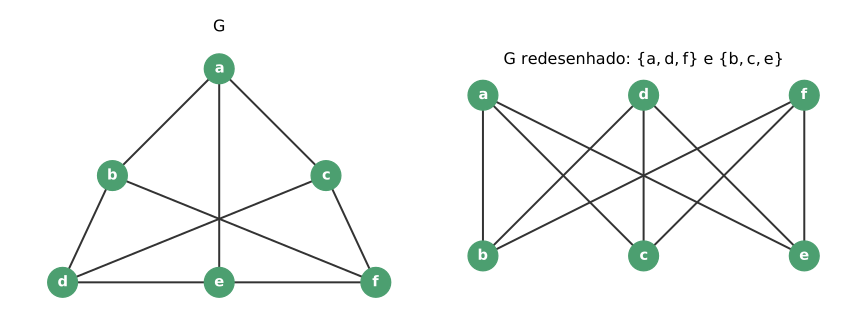
Grafo redesenhado como K3,3
Exemplo 3: grafo de Petersen. O grafo de Petersen tem um pentágono externo e uma estrela interna , ligados pelas arestas . Tomando as partições e e usando os vértices (entre e ), (entre e ) e (entre e ) como vértices de subdivisão, obtemos um subgrafo homeomorfo a . O vértice e suas arestas , , (tracejadas) não fazem parte do subgrafo. Logo, o grafo de Petersen não é planar.
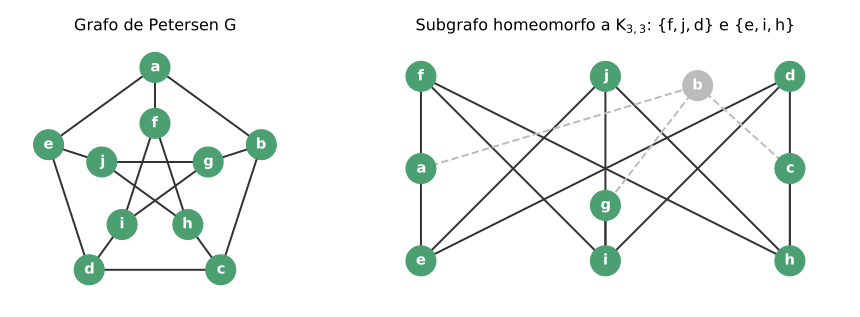
Subgrafo do grafo de Petersen homeomorfo a K3,3
5.12.4 Grafo dual
Dado um grafo planar (com um desenho planar fixado), o grafo dual é construído assim:
Cada face de vira um vértice de .
a) Para cada aresta de que separa duas faces distintas, há em uma aresta entre os vértices dessas faces. b) Para cada aresta de que não separa duas faces distintas (a mesma face está dos dois lados), há em um laço no vértice dessa face.
Note que pode ter arestas paralelas e laços, isto é, é em geral um multigrafo.
Exemplo 1: triângulo com duas arestas pendentes. é um triângulo com uma aresta pendente para dentro (face 1) e outra para fora (face 2). O dual tem dois vértices, 1 e 2:
3 arestas paralelas entre 1 e 2, uma para cada lado do triângulo (que separa a face 1 da face 2);
um laço em 1, para a aresta pendente interna;
um laço em 2, para a aresta pendente externa.
Dual do triângulo com arestas pendentes
Conferência: tem 5 vértices, 5 arestas e 2 faces (), e tem 2 vértices e 5 arestas, uma por aresta de .
Exemplo 2: . é desenhado como um triângulo com um vértice central, o que produz 4 faces triangulares: as internas e a externa 4. Como duas faces quaisquer compartilham exatamente uma aresta, tem os 4 vértices ligados dois a dois, isto é, é isomorfo a . Dizemos que é autodual.
Dual de K4