Introdução sobre algoritmos de divisão e conquista
Divisão e conquista é uma técnica de projeto de algoritmos que é naturalmente apresentada de forma indutiva, isto é, vamos utilizar noções de recursão para resolver problemas. A inspiração para o nome vem da ideia de “dividir para conquistar”, onde um problema maior é dividido em problemas menores (subproblemas), que são resolvidos recursivamente. Em computação, muitas vezes estratégias de divisão e conquista são usadas para melhorar a complexidade assintótica de algoritmos, especialmente aqueles que possuem complexidade polinomial considerável. A técnica consiste em abstrair o algoritmo que soluciona um problema em três etapas:
Divisão: aqui problemas maiores são divididos em problemas menores, chamados de subproblemas.
Conquista: aqui subproblemas são resolvidos recursivamente.
Combinação: aqui as soluções dos subproblemas são combinadas para formar a solução de problemas maiores.
Dois pontos principais a se destacar: (1) subproblema é uma expressão reservada, significando um problema que tem as mesmas características do original (em termos de formato de entrada e saída), mas que o tamanho da entrada é necessariamente menor; (2) um algoritmo de divisão e conquista é naturalmente um algoritmo recursivo, mas nem todo algoritmo recursivo é um algoritmo de divisão e conquista.
A complexidade de um algoritmos de divisão e conquista deve ser representada, portanto, através de uma recorrência, que é uma equação ou desigualdade que define a função de complexidade em termos de valores menores dela mesma. De fato, toda recorrência de divisão e conquista pode ser expressa da seguinte forma:
Na expressão acima, indicam a complexidade das etapas de divisão, conquista e combinação, respectivamente. Como veremos, apenas a primeira tem a ver com recursividade, as outras duas são iterativas e não relacionadas com as chamadas recursivas do algoritmo.
Resolvendo recorrências usando expansão de termos
Método informal que encontra a função fechada da recorrência ao expandir os termos da recorrência até que um padrão seja identificado. O que é esse padrão? Bom, ao repetir a aplicação da recorrência e ao simplificar os termos não-recursivos, começamos a perceber que certas expressões começam a se repetir e mais, essas expressões são diretamente relacionadas com o número de vezes que a recorrência foi expandida (número de passos).
Exemplo 1: recorrência linear simples (não é de divisão e conquista)
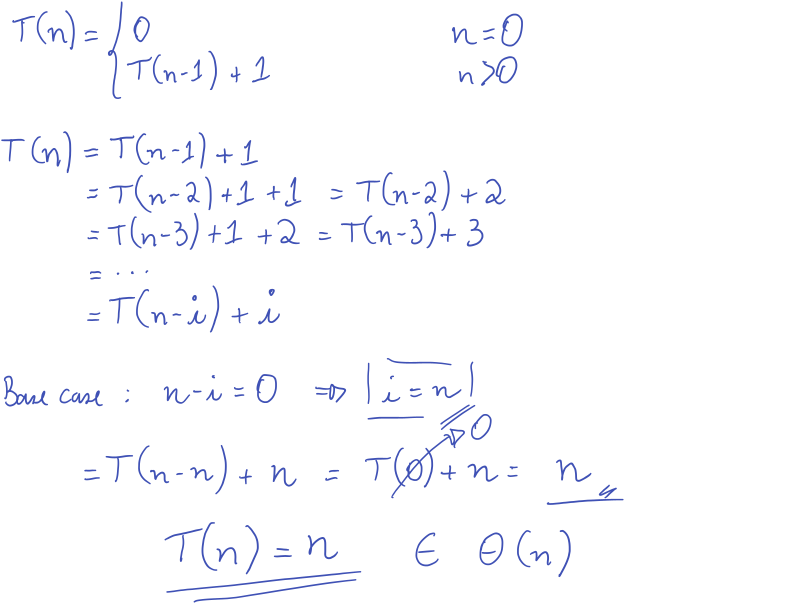
Exemplo 2: recorrência log-linear
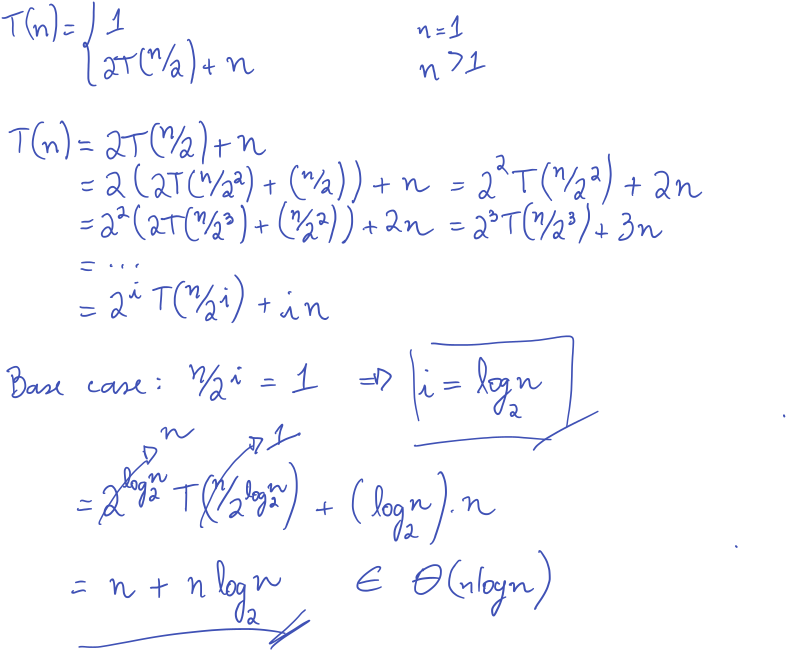
Resolvendo recorrências usando árvores de recursão
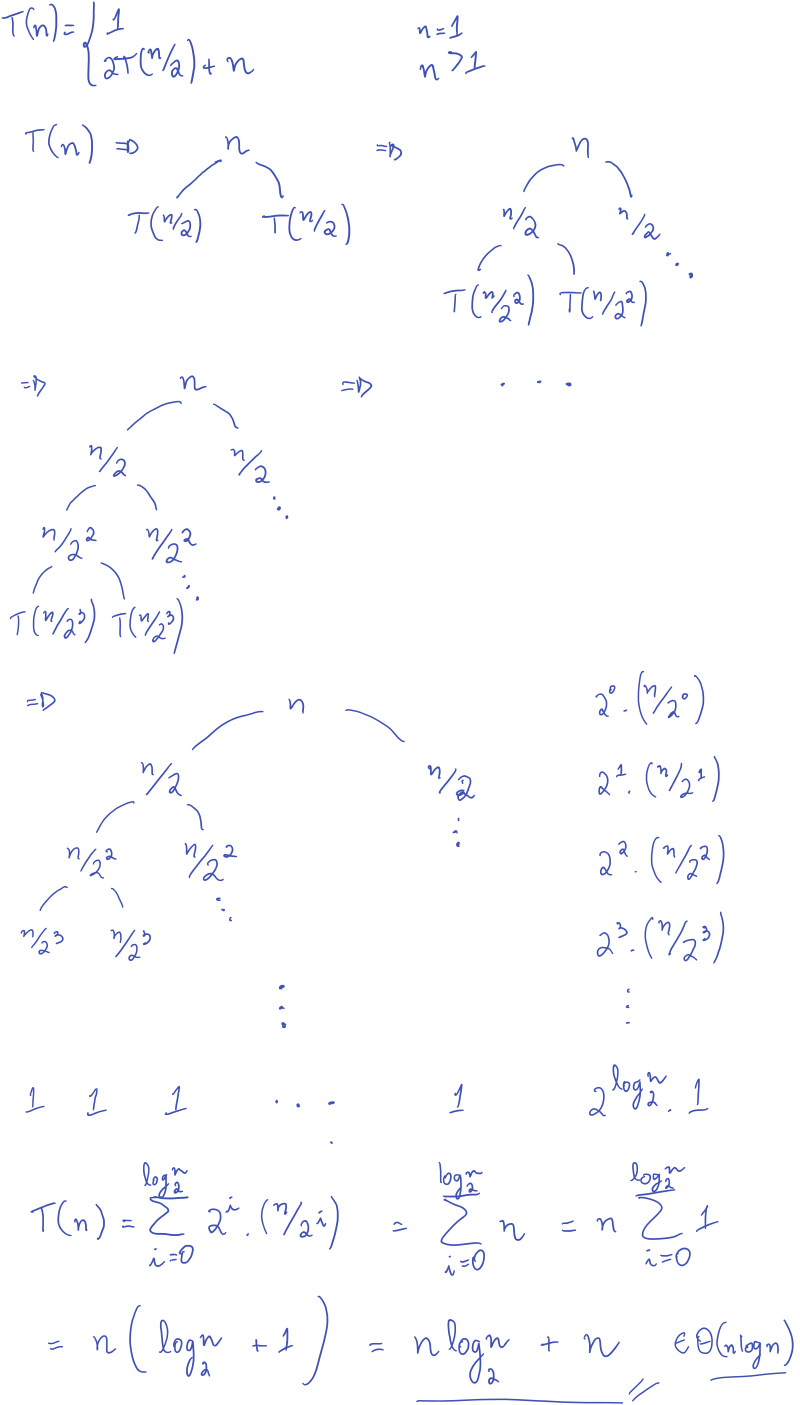
Método informal e visual que também é baseado em expansão de termos, mas organizada em uma árvore. Cada nó da árvore representa a complexidade associada a uma chamada recursiva, enquanto os filhos representam o mesmo para os subproblemas resolvidos nas chamadas recursivas. Com a árvore totalmente expandida, basta somar os custos de todos os nós para obter a complexidade total do algoritmo. A soma pode ser feita nível a nível (cada nível representa o custo de chamadas recursivas associadas a uma mesma profundidade) e, posteriormente, somando os custos agregados dos níveis.
Exemplo 1
Resolvendo recorrências usando indução matemática (método da substituição)
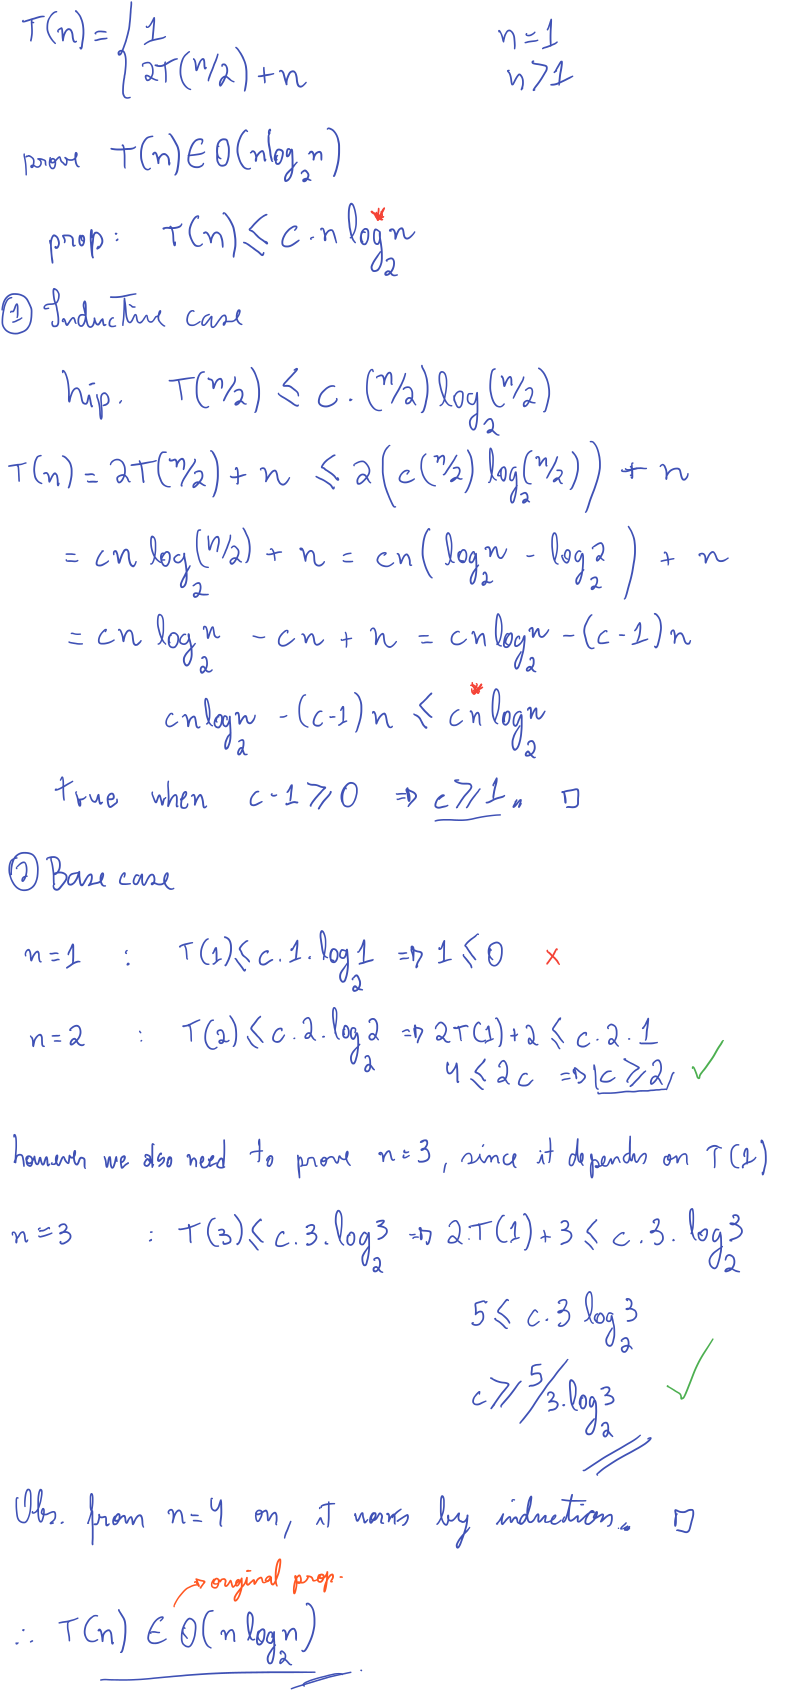
Método formal que usa indução matemática para provar um limite assintótico para a recorrência. Para isso, utiliza-se a definição formal das notações assintóticas ().
Exemplo 1
Resolvendo recorrências usando o teorema mestre
Método formal usado para recorrências do tipo:
O teorema consiste em comparar com a grandeza e o que dominar assintoticamente é a solução da recorrência. A função representa o custo associado às operações que são efetuadas dentro de uma única chamada recursiva, ignorando o custo adicional das outras chamadas recursivas (conquista). Por outro lado, representa o contrário, o custo associado às chamadas recursivas:
se : significa que o custo dominante da recorrência acontece nos filhos das (sub)árvores, isto é, o custo dos níveis da árvore de recursão vai progressivamente aumentando.
se : significa que cada nível contribui igualmente para o custo.
se : significa que o custo dominante da recorrência se concentra nas raízes das (sub)árvores, isto é, o custo dos níveis da árvore de recursão vai progressivamente diminuindo.
Cada uma dessas situações descreve um caso do teorema, que acompanha condições necessárias e também a conclusão a ser tirada sobre a complexidade assintótica da recorrência em cada caso.
Caso 1. Se para , então
Caso 2. Se , então
Caso 3. Se para e atender uma condição de regularização para e a partir de , então
Exemplo 1
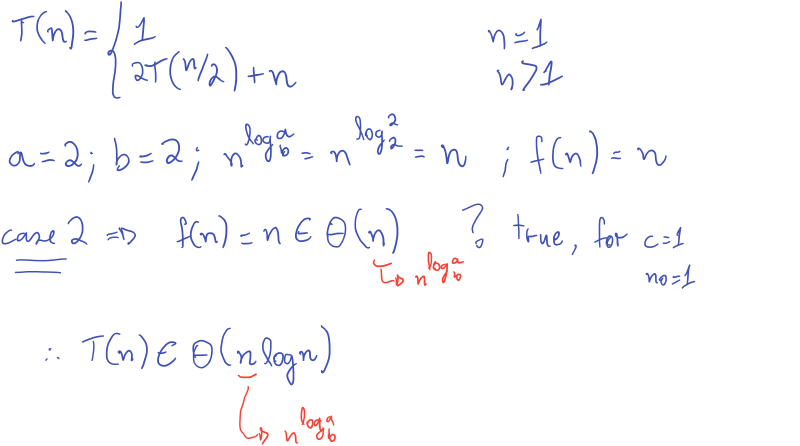
Resolvendo recorrências usando o Akra-Bazzi
Se trata de uma generalização do teorema mestre, possibilitando a solução de recorrências do tipo:
Onde: , é uma função assintoticamente positiva. Além disso, seja a única raíz real da equação:
O teorema de Akra-Bazzi conclui um limite assintótico justo para :
Estudo de caso: ordenação por intercalação (merge sort)
merge(left, right, a)
// argumentos:
// left: subarranjo ordenado com n elementos
// right: subarranjo ordenado com m elementos
// a: arranjo de saída com n + m posições

  n = |left|
  m = |right|
  i = 1
  j = 1
  k = 1
  while i <= n and j <= m
    if left[i] < right[j]
      a[k] = left[i]
      i = i + 1
    else
      a[k] = right[j]
      j = j + 1
    k = k + 1
  while i <= n
    a[k] = left[i]
    i = i + 1
    k = k + 1
  while j <= m
    a[k] = right[j]
    j = j + 1
    k = k + 1
merge-sort(a)
// argumentos:
// a: arranjo a ser ordenado, com n = |a| elementos
n = |a|
if n == 1 or n == 0
return
mid = floor(n / 2)
left = a[1, ..., mid]
right = a[mid+1, ..., n]
merge-sort(left)
merge-sort(right)
merge(left, right, a)Estudo de caso: ordenação usando quick sort
partition(a, l, r)
// argumentos:
// a: arranjo a ser particionado, indexado de l a r, inclusive
// l: posição inicial do subarranjo
// r: posição final do subarranjo

  pivot = a[r]
  i = l - 1
  for j = l to r-1
    if a[j] <= pivot
      i = i + 1
      swap(a, j, i)    // troca elementos de posição
  swap(a, i+1, r)
  return i+1
Estudo de caso: subarranjo de soma máxima
O subarranjo de soma máxima pode estar: (1) na metade esquerda; (2) na metade
direita; (3) cruzando o meio. Observe que, se estamos no caso (3), a restrição
nos ajuda a encontrar o melhor subarranjo: a partir do meio, basta adicionarmos
elementos à esquerda rastreando em que posição a soma fica máxima e o mesmo à
direita. Assim, (1) e (2) são resolvidos diretamente pela recursão durante a
conquista dos subproblemas e (3) é resolvido pelo procedimento
max-sum-crossing-mid de complexidade linear , onde n é o tamanho do
arranjo.
max-sum-subarray(a, l, r)
// argumentos:
// a: arranjo de números, indexado de l a r, inclusive
// l: posição inicial do subarranjo
// r: posição final do subarranjo

  if l == r
    return (l, r, a[l])
  mid = floor((l + r) / 2)
  (l1, r1, s1) = max-sum-subarray(a, l, mid)
  (l2, r2, s2) = max-sum-subarray(a, mid+1, r)
  (l3, r3, s3) = max-sum-crossing-mid(a, l, r, mid)
  if s1 > s2 and s1 > s3
    return (l1, r1, s1)
  else if s2 > s3
    return (l2, r2, s2)
  else
    return (l3, r3, s3)
max-sum-crossing-mid(a, l, r, mid)
// argumentos:
// a: arranjo de números, indexado de l a r, inclusive
// l: posição inicial do subarranjo
// r: posição final do subarranjo
// mid: posição do meio, que separa as duas metades
s1 = -infinity
s = 0
for i = mid down to l
s = s + a[i]
if s > s1
s1 = s
l1 = i
s2 = -infinity
s = 0
for i = mid+1 to r
s = s + a[i]
if s > s2
s2 = s
r1 = i
return (l1, r1, s1 + s2)Estudo de caso: número de inversões em um arranjo
count-inversions(a)
// argumentos:
// a: arranjo a ser analisado, com n = |a| elementos

  n = |a|
  if n == 1 or n == 0
    return 0
  mid = floor(n / 2)
  left = a[1, ..., mid]
  right = a[mid+1, ..., n]
  inv_left = count-inversions(left)
  inv_right = count-inversions(right)
  inv_merge = merge-count(left, right, a)
  return inv_left + inv_right + inv_merge
merge-count(left, right, a)
// argumentos:
// left: subarranjo ordenado com n elementos
// right: subarranjo ordenado com m elementos
// a: arranjo de saída com n + m posições
n = |left|
m = |right|
i = 1
j = 1
k = 1
inv_count = 0
while i <= n and j <= m
if left[i] <= right[j]
a[k] = left[i]
i = i + 1
else
a[k] = right[j]
j = j + 1
inv_count = inv_count + (n - i + 1) // conta inversões
k = k + 1
while i <= n
a[k] = left[i]
i = i + 1
k = k + 1
while j <= m
a[k] = right[j]
j = j + 1
k = k + 1
return inv_count